DeerFlow 2.0 실측: ByteDance 오픈소스 SuperAgent, 24시간 AI 직원 심층 분석
1. DeerFlow 2.0이란? 심층 연구에서 슈퍼 에이전트로의 진화
2026년 2월, ByteDance는 DeerFlow 2.0을 공식 출시했습니다. 이는 처음부터 완전히 다시 작성한 것으로, 1.x 버전과 코드를 전혀 공유하지 않으며, 182개의 PR을 통합하여 DeerFlow를 “심층 연구 프레임워크”에서 완전한 오픈소스 SuperAgent 엔진으로 진화시켰습니다.
DeerFlow의 정식 명칭은 Deep Exploration and Efficient Research Flow(심층 탐색 및 효율적 연구 흐름)입니다. GitHub에서 83,000개 이상의 Star를 획득하여 2026년 가장 인기 있는 오픈소스 AI 프로젝트 중 하나가 되었습니다.
1.1 한 줄로 정의
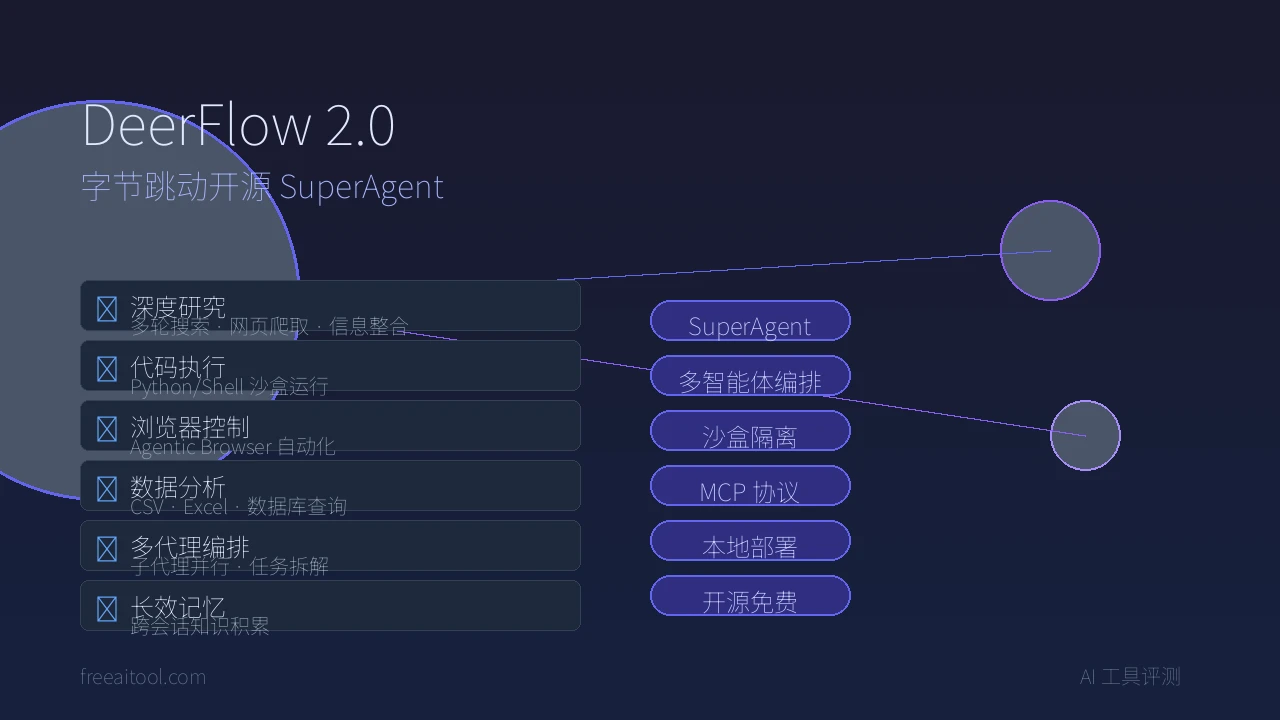
DeerFlow 2.0은 서브 에이전트를 오케스트레이션하고, 메모리를 관리하고, 샌드박스를 격리하여 확장 가능한 스킬 시스템을 통해 거의 모든 복잡한 작업을 완료할 수 있는 오픈소스 SuperAgent Harness입니다.
1.0 버전이 “심층 연구”만 수행했던 것과 달리, 2.0 버전의 DeerFlow는 다음을 수행할 수 있습니다:
- 🔬 심층 연구: 다중 검색, 웹 크롤링, 정보 통합
- 💻 코드 작성: 샌드박스에서 Python/Shell 실행, 실행 가능한 프로그램 생성
- 🌐 웹 탐색: 내장된 Agentic 브라우저 제어로 웹 페이지 자동 조작
- 📊 데이터 분석: CSV, Excel, 데이터베이스 쿼리 처리
- 📝 콘텐츠 제작: 보고서, PPT, 문서 생성
- 🤖 멀티태스크 오케스트레이션: 복잡한 작업을 여러 서브 에이전트로 분해하여 병렬 실행
1.2 왜 주목해야 하는가?
| 특성 | DeerFlow 2.0 | 전통적 AI 어시스턴트 |
|---|---|---|
| 작업 복잡도 | 장기적, 다단계, 교차 도메인 | 단일 턴 질의응답 |
| 실행 환경 | 격리된 샌드박스, 코드 실행 가능 | 텍스트 생성만 |
| 메모리 기능 | 교차 세션 영구 메모리 | 메모리 없음 또는 단기 컨텍스트 |
| 도구 확장 | MCP 프로토콜 + 사용자 정의 스킬 | 고정된 기능 세트 |
| 멀티 에이전트 | 서브 에이전트 오케스트레이션, 병렬 처리 | 단일 에이전트 직렬 |
| 배포 방식 | 완전 로컬, 데이터 외부 유출 없음 | 클라우드 API 의존 |
2. 핵심 기술 아키텍처 분석
DeerFlow 2.0의 아키텍처 설계는 ByteDance의 대규모 AI 시스템 엔지니어링 경험을 반영합니다. 층별로 분해해 보겠습니다.
2.1 전체 아키텍처: 3계층 분리
┌─────────────────────────────────────────────────────┐
│           클라이언트 (브라우저 / TUI 터미널)           │
└──────────────────────┬──────────────────────────────┘
                       │
                       ▼
┌─────────────────────────────────────────────────────┐
│              Nginx 리버스 프록시 (포트 2026)           │
│    /api/*  → Gateway API (8001)                      │
│    /*      → Frontend (3000)                         │
└──────────────────────┬──────────────────────────────┘
                       │
          ┌────────────┴────────────┐
          ▼                         ▼
┌──────────────────┐      ┌──────────────────┐
│  Gateway API     │      │   Frontend       │
│  (FastAPI:8001)  │      │  (Next.js:3000)  │
│                  │      │                  │
│ • Agent Runtime  │      │ • React UI       │
│ • LangGraph 호환 │      │ • 채팅 인터페이스 │
│ • SSE 스트리밍   │      │ • 프로젝트 문서   │
│ • MCP/Skills     │      │ • 아티팩트 뷰어  │
└──────────────────┘      └──────────────────┘
핵심 설계 결정: Agent Runtime은 FastAPI Gateway에 직접 내장되어 있으며, LangGraph Server를 별도로 배포하지 않습니다. 이는 운영 비용이 적음을 의미합니다 — 하나의 프로세스가 API 요청과 Agent 실행을 모두 처리합니다.
2.2 미들웨어 체인: 8계층 처리 파이프라인
각 Agent 실행 전에 요청은 8개의 미들웨어 계층을 통과합니다:
- ThreadDataMiddleware — 작업 공간, 업로드 디렉토리, 출력 디렉토리 초기화
- UploadsMiddleware — 사용자가 업로드한 파일(문서, 이미지) 처리
- SandboxMiddleware — 샌드박스 실행 환경 획득
- SummarizationMiddleware — 컨텍스트 압축(토큰 오버플로우 방지)
- TitleMiddleware — 대화 제목 자동 생성
- TodoListMiddleware — 작업 추적(계획 모드)
- ViewImageMiddleware — 비전 모델 지원(이미지 이해)
- ClarificationMiddleware — 명확화 요청 처리
이 미들웨어 패턴은 웹 프레임워크의 설계 철학을 차용한 것으로, 각 계층은 단일 책임을 가지며 플러그인 가능합니다.
2.3 샌드박스 시스템: 안전한 코드 실행
DeerFlow의 샌드박스는 일반 챗봇과 구별되는 핵심 기능입니다. 두 가지 모드를 제공합니다:
| 모드 | 사용 시나리오 | 격리 수준 |
|---|---|---|
| LocalSandbox | 로컬 개발, 개인 사용 | 프로세스 수준 격리 |
| DockerSandbox | 프로덕션 배포, 다중 사용자 | 컨테이너 수준 격리 |
샌드박스는 완전한 파일 시스템 작업을 지원합니다: 명령 실행, 파일 읽기/쓰기, 디렉토리 나열. 모든 작업은 가상 경로 매핑을 통해 구현되며, Agent는 호스트 머신의 실제 파일 시스템에 접근할 수 없습니다.
2.4 서브 에이전트 오케스트레이션: 작업 분해 및 병렬 처리
DeerFlow 2.0의 핵심 혁신은 서브 에이전트 오케스트레이션 시스템입니다. 복잡한 작업에 직면했을 때, 메인 에이전트(Lead Agent)는 다음을 수행합니다:
- 작업 분석: 작업 목표와 제약 조건 이해
- 서브 작업 분해: 큰 작업을 독립적으로 실행 가능한 서브 작업으로 분할
- 서브 에이전트 할당: 각 서브 작업에 특화된 서브 에이전트 생성
- 병렬 실행: 여러 서브 에이전트가 각자의 샌드박스에서 동시에 작업
- 결과 통합: 모든 서브 에이전트의 출력을 수집하여 최종 결과로 통합
# 서브 에이전트 오케스트레이션 의사 코드
lead_agent.receive("10개 경쟁사의 가격 전략을 분석하고 보고서 생성")
  → sub_agent_1: 경쟁사 A, B, C의 가격 조사
  → sub_agent_2: 경쟁사 D, E, F의 가격 조사
  → sub_agent_3: 경쟁사 G, H, I, J의 가격 조사
  → sub_agent_4: 데이터 집계, 비교 보고서 생성
2.5 영구 메모리 시스템 (DeerMem)
DeerFlow의 메모리 시스템은 두 계층으로 구성됩니다:
- 세션 메모리: 현재 대화의 컨텍스트, LangGraph의 Checkpoint 메커니즘을 통해 영구화
- 장기 메모리: 교차 세션 지식 축적, 로컬 파일 시스템에 저장되며 시맨틱 검색 지원
장기 메모리를 통해 DeerFlow는 이전 작업 결과, 설정, 프로젝트 배경을 “기억”할 수 있어 “사용할수록 더 똑똑해집니다”.
2.6 스킬 시스템 (Skills)
DeerFlow의 스킬 시스템은 Markdown 파일을 기반으로 정의되며, 각 스킬은 다음을 포함합니다:
- 트리거 조건(언제 이 스킬을 사용할지)
- 실행 단계(구체적으로 무엇을 할지)
- 도구 의존성(어떤 도구가 필요한지)
- 출력 형식(결과를 어떻게 표시할지)
스킬은 MCP(Model Context Protocol) 프로토콜을 통해 외부 서비스와 통합하거나 완전히 사용자 정의할 수 있습니다.
3. 완전한 배포 가이드
3.1 환경 요구 사항
| 구성 요소 | 최소 버전 | 권장 버전 |
|---|---|---|
| Python | 3.12+ | 3.12 |
| Node.js | 22+ | 22 LTS |
| Docker | 24+ | 24+(프로덕션 배포) |
| 메모리 | 8GB | 16GB+ |
| 디스크 | 10GB | 20GB+ |
3.2 방법 1: Docker 배포(권장)
# 1. 저장소 복제
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 2. 환경 변수 구성
cp .env.example .env
# .env를 편집하여 LLM API 키 입력
# 지원: OpenAI, Anthropic, Google Gemini, Doubao, DeepSeek 등

# 3. 서비스 시작
docker compose up -d

# 4. 접근
# 프론트엔드: http://localhost:2026
# API 인터페이스: http://localhost:2026/api
3.3 방법 2: 로컬 개발 배포
# 1. 저장소 복제
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 2. 백엔드 설정
cd backend
python -m venv .venv
source .venv/bin/activate
pip install -e ".[dev]"

# 구성 복사 및 편집
cp config.yaml.example config.yaml
# config.yaml을 편집하여 모델 API 키 구성

# 3. 프론트엔드 설정
cd ../frontend
npm install

# 4. 서비스 시작
# 터미널 1: 백엔드 시작
cd backend && python -m app.gateway.app

# 터미널 2: 프론트엔드 시작
cd frontend && npm run dev

# 5. http://localhost:3000 접근
3.4 모델 구성
DeerFlow는 여러 LLM 제공업체를 지원하며, 공식 권장 사항은 다음과 같습니다:
| 모델 | 사용 시나리오 | 비고 |
|---|---|---|
| Doubao Seed-2.0-Code | 코딩 작업 | ByteDance 자체 개발, DeerFlow와 깊이 통합 |
| DeepSeek v3.2 | 일반 작업 | 가성비 높음, 중국어 능력 우수 |
| Kimi 2.5 | 긴 텍스트 처리 | 초장기 컨텍스트 창 |
| Claude 3.5 Sonnet | 복잡한 추론 | 영어 시나리오의 첫 번째 선택 |
| GPT-4o | 멀티모달 작업 | 이미지-텍스트 혼합 이해 |
config.yaml에서 구성:
models:
  default:
    provider: openai
    model: deepseek-v3.2
    api_key: ${DEEPSEEK_API_KEY}

  reasoning:
    provider: anthropic
    model: claude-3.5-sonnet
    api_key: ${ANTHROPIC_API_KEY}
3.5 샌드박스 구성
# config.yaml
sandbox:
  # 로컬 개발용 LocalSandbox
  provider: local

  # 프로덕션 배포용 DockerSandbox
  # provider: docker
  # docker:
  #   image: python:3.12-slim
  #   memory_limit: "2g"
  #   cpu_limit: "2.0"
4. 실전 사례: DeerFlow로 경쟁사 분석 수행
실제 사례를 통해 DeerFlow 2.0의 능력을 체험해 보겠습니다.
4.1 작업 설명
“Notion, Obsidian, Logseq 세 가지 노트 도구의 가격 전략, 핵심 기능 차이, 사용자 평가를 분석하고 비교 보고서를 작성해 주세요.”
4.2 DeerFlow의 실행 과정
1단계: 작업 분해
Lead Agent는 작업을 4개의 서브 작업으로 분해합니다:
- Notion의 가격, 기능, 사용자 평가 조사
- Obsidian의 가격, 기능, 사용자 평가 조사
- Logseq의 가격, 기능, 사용자 평가 조사
- 비교하여 보고서 생성
2단계: 병렬 실행
3개의 서브 에이전트가 샌드박스에서 동시에 시작되어, 각각 브라우저 도구를 사용하여 대상 제품의 공식 웹사이트, 가격 페이지, Reddit/G2 평가 페이지에 접근합니다.
3단계: 정보 통합
각 서브 에이전트는 수집한 데이터를 구조화된 형식으로 정리하여 샌드박스 파일 시스템에 저장합니다.
4단계: 보고서 생성
집계 서브 에이전트는 코드 실행 도구를 호출하여 데이터를 Markdown 보고서 + 비교 테이블로 렌더링하여 아티팩트 디렉토리에 출력합니다.
전체 과정은 약 3-5분 만에 완료됩니다. 동일한 작업을 수동으로 수행하려면 최소 2-3시간이 걸립니다.
5. 비교: DeerFlow vs AutoGPT vs CrewAI vs LangGraph
| 차원 | DeerFlow 2.0 | AutoGPT | CrewAI | LangGraph |
|---|---|---|---|---|
| 포지셔닝 | SuperAgent 엔진 | 자율 AI 에이전트 | 역할극 멀티 에이전트 | 상태 그래프 오케스트레이션 프레임워크 |
| 아키텍처 | 미들웨어 체인 + 서브 에이전트 | 단일 에이전트 루프 | 역할 협업 | 유향 그래프 상태 머신 |
| 샌드박스 | ✅ Docker/로컬 | ❌ 네이티브 샌드박스 없음 | ❌ 네이티브 샌드박스 없음 | ❌ 샌드박스 없음 |
| 메모리 | ✅ 교차 세션 영구 메모리 | ⚠️ 제한적 | ⚠️ 제한적 | ✅ Checkpoint |
| 스킬 확장 | ✅ Markdown 스킬 + MCP | ⚠️ 플러그인 | ✅ 도구 정의 | ✅ 사용자 정의 노드 |
| 브라우저 제어 | ✅ 내장 | ✅ 있음 | ❌ 통합 필요 | ❌ 통합 필요 |
| Web UI | ✅ Next.js 아름다운 인터페이스 | ⚠️ 기본 인터페이스 | ❌ 없음 | ⚠️ Studio |
| 배포 난이도 | 보통(Docker 원클릭) | 간단 | 간단 | 보통 |
| 적용 시나리오 | 장기적 복잡한 작업 | 간단한 자율 작업 | 명확한 역할 분담 | 세밀한 제어 흐름 필요 |
| Star 수 | 83K+ | 170K+ | 30K+ | 15K+ |
| 라이선스 | MIT | MIT | MIT | MIT |
5.1 선택 가이드
- DeerFlow 2.0 선택: 장기적 복잡한 작업 처리, 코드 실행 샌드박스 필요, 아름다운 Web UI, 데이터 프라이버시 중시(로컬 배포)
- AutoGPT 선택: 간단한 자율 작업 루프만 필요, 빠른 프로토타입 검증
- CrewAI 선택: 작업을 여러 역할로 명확히 분할 가능, 팀 협업 시뮬레이션
- LangGraph 선택: 실행 흐름에 대한 세밀한 제어 필요, 사용자 정의 Agent 애플리케이션 구축
6. DeerFlow 2.0의 하이라이트와 부족점
✅ 하이라이트
- 진정한 SuperAgent 아키텍처: 단순한 챗봇이 아니라 여러 서브 에이전트를 오케스트레이션하여 복잡한 작업을 완료하는 엔진
- 안전 우선의 샌드박스: Docker 수준 격리, 코드 실행이 호스트 머신에 영향을 미치지 않음
- 유연한 스킬 시스템: Markdown으로 스킬 정의, 진입 장벽 낮음, 공유 용이
- MCP 프로토콜 지원: 외부 도구 및 서비스에 연결 가능, 개방된 생태계
- 완전 로컬 배포: 데이터가 머신을 떠나지 않음, 기업 수준 프라이버시 요구에 적합
- 아름다운 Web UI: Next.js로 구축, 일류의 인터랙션 경험
- ByteDance 지원: 83K+ Star, 활발한 커뮤니티, 빠른 반복
⚠️ 부족점
- 높은 리소스 소비: 완전 배포에 16GB+ 메모리 필요, 경량 VPS에서는 실행 불가
- 모델 의존성: 자체 LLM API 키 필요, 운영 비용이 적지 않음
- 학습 곡선: 구성 항목이 많아 초보자가 시작하는 데 시간 필요
- 중국어 문서 개선 필요: 핵심 문서는 주로 영어
- 2.0은 1.x와 호환되지 않음: 업그레이드하려면 완전한 재배포 필요
7. 자주 묻는 질문 FAQ
Q1: DeerFlow 2.0은 무료인가요?
네, DeerFlow 2.0은 MIT 오픈소스 라이선스를 사용하며 완전히 무료로 사용할 수 있습니다. 단, 실행 시 LLM API(DeepSeek, OpenAI 등)가 필요하며, 이러한 API 호출에는 비용이 발생합니다.
Q2: DeerFlow는 GPU 없는 머신에서 실행할 수 있나요?
가능합니다. DeerFlow 자체는 로컬 모델을 호출하지 않고 API를 통해 클라우드 LLM을 호출합니다. 따라서 CPU 머신으로 실행 가능하며, GPU는 필요하지 않습니다.
Q3: DeerFlow와 ChatGPT의 차이점은 무엇인가요?
ChatGPT는 클라우드 기반 대화 제품으로 데이터는 OpenAI 서버에 저장됩니다. DeerFlow는 로컬에 배포된 Agent 프레임워크로 데이터가 완전히 사용자 머신에 있습니다. DeerFlow는 코드 실행, 브라우저 조작, 파일 관리도 가능합니다 — 이것은 ChatGPT가 할 수 없는 것입니다.
Q4: DeerFlow는 어떤 언어 모델을 지원하나요?
모든 주요 LLM을 지원합니다: OpenAI GPT-4o, Anthropic Claude, Google Gemini, DeepSeek, Doubao, Kimi, Qwen 등. OpenAI 호환 API를 통해 연결됩니다.
Q5: DeerFlow는 개인 개발자에게 적합한가요, 아니면 기업에 적합한가요?
둘 다 적합합니다. 개인 개발자는 LocalSandbox 모드로 빠르게 시작할 수 있습니다. 기업은 DockerSandbox + 다중 사용자 격리 모드를 사용하여 프로덕션 배포를 수행할 수 있습니다.
Q6: DeerFlow 1.x에서 2.0으로 업그레이드하는 방법은?
2.0은 완전히 다시 작성된 것으로 직접 업그레이드는 지원되지 않습니다. 2.0 버전을 재배포해야 합니다. 1.x 버전은 main-1.x 브랜치에서 계속 유지보수되고 있지만, 새 기능 개발은 2.0에 집중되고 있습니다.
8. 결론
DeerFlow 2.0은 오픈소스 AI Agent 프레임워크의 중요한 이정표를 대표합니다. 더 이상 “대화하는 AI”에 만족하지 않고, 생각하고, 실행하고, 기억하는 24시간 가동 AI 직원으로 진화했습니다.
개발자에게 DeerFlow 2.0의 가치는 다음과 같습니다:
- AI 애플리케이션 개발 장벽 낮춤: 처음부터 Agent 인프라를 구축할 필요 없음
- 복잡한 작업 자동화 수준 향상: 멀티 에이전트 오케스트레이션으로 AI가 실제로 “작업을 수행”
- 데이터 보안 보장: 완전 로컬 배포, 데이터 외부 유출 없음
오픈소스이면서 강력하고 로컬 배포 가능한 AI Agent 프레임워크를 찾고 있다면, DeerFlow 2.0은 진지하게 평가할 가치가 있습니다.
참고 링크:
이 심층 분석이 도움이 되었기를 바랍니다! 이미 DeerFlow 2.0을 사용하고 계신다면, 댓글에서 사용 경험을 공유해 주세요.