DeerFlow 2.0 实测:字节跳动开源 SuperAgent,全天候 AI 员工深度解析
一、DeerFlow 2.0 是什么?从深度研究到超级智能体的进化
2026 年 2 月,字节跳动正式发布了 DeerFlow 2.0,这是一次从零开始的重写——与 1.x 版本不共享任何代码,汇聚了 182 个 PR,将 DeerFlow 从一个”深度研究框架”彻底进化为开源 SuperAgent 引擎。
DeerFlow 的全称是 Deep Exploration and Efficient Research Flow(深度探索与高效研究流)。在 GitHub 上已经斩获超过 83,000 Stars,成为 2026 年最热门的开源 AI 项目之一。
1.1 一句话定位
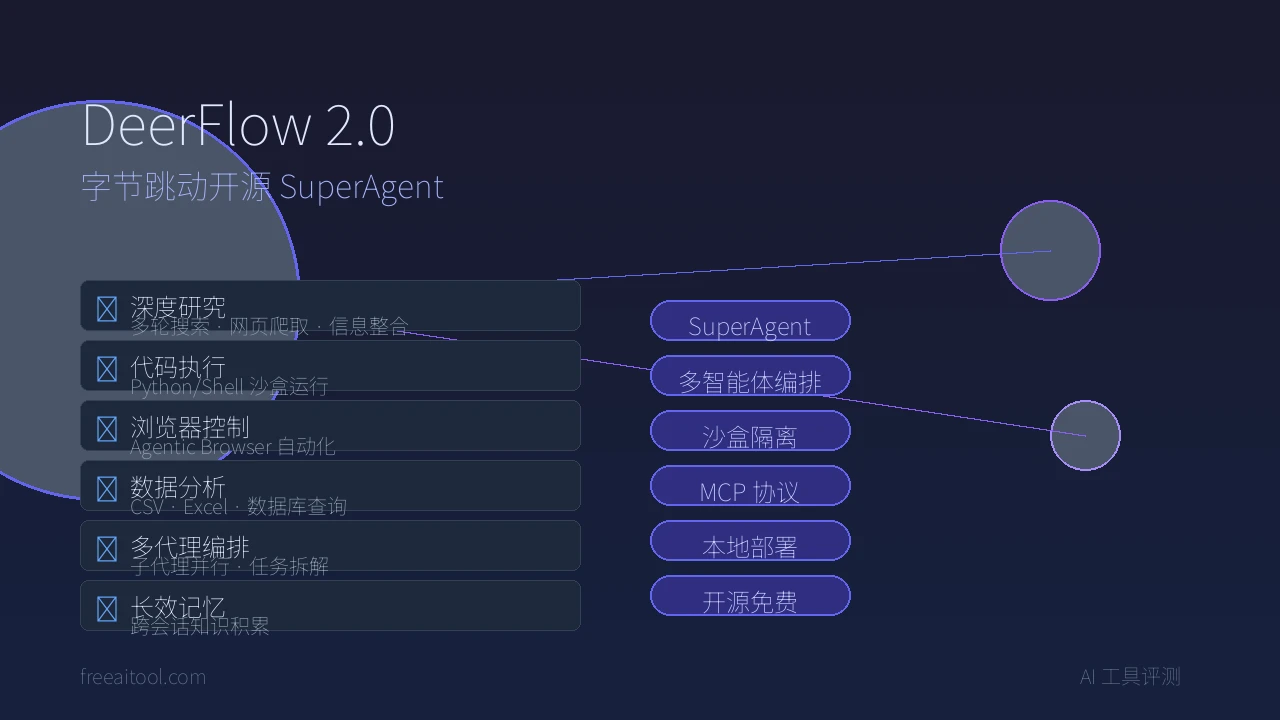
DeerFlow 2.0 是一个开源的超级智能体调度框架(SuperAgent Harness),它能编排子代理、管理记忆、隔离沙盒,通过可扩展的技能系统完成几乎任何复杂任务。
与 1.0 版本只做”深度研究”不同,2.0 版本的 DeerFlow 可以:
- 🔬 深度研究:多轮搜索、网页爬取、信息整合
- 💻 编写代码:在沙盒中执行 Python/Shell,生成可运行程序
- 🌐 浏览网页:内置 Agentic Browser 控制,自动操作网页
- 📊 数据分析:处理 CSV、Excel、数据库查询
- 📝 内容创作:生成报告、PPT、文档
- 🤖 多任务编排:将复杂任务拆解为多个子代理并行执行
1.2 为什么值得关注?
| 特性 | DeerFlow 2.0 | 传统 AI 助手 |
|---|---|---|
| 任务复杂度 | 长程、多步骤、跨领域 | 单轮问答 |
| 执行环境 | 隔离沙盒,可执行代码 | 纯文本生成 |
| 记忆能力 | 跨会话长效记忆 | 无记忆或短期上下文 |
| 工具扩展 | MCP 协议 + 自定义技能 | 固定功能集 |
| 多代理 | 子代理编排,并行处理 | 单代理串行 |
| 部署方式 | 完全本地,数据不出门 | 云端 API 依赖 |
二、核心技术架构解析
DeerFlow 2.0 的架构设计体现了字节跳动在大规模 AI 系统上的工程经验。我们逐层拆解。
2.1 整体架构:三层分离
┌─────────────────────────────────────────────────────┐
│           Client(浏览器 / TUI 终端)                  │
└──────────────────────┬──────────────────────────────┘
                       │
                       ▼
┌─────────────────────────────────────────────────────┐
│              Nginx 反向代理(端口 2026)               │
│    /api/*  → Gateway API (8001)                      │
│    /*      → Frontend (3000)                         │
└──────────────────────┬──────────────────────────────┘
                       │
          ┌────────────┴────────────┐
          ▼                         ▼
┌──────────────────┐      ┌──────────────────┐
│  Gateway API     │      │   Frontend       │
│  (FastAPI:8001)  │      │  (Next.js:3000)  │
│                  │      │                  │
│ • Agent Runtime  │      │ • React UI       │
│ • LangGraph 兼容 │      │ • 聊天界面        │
│ • SSE 流式响应   │      │ • 项目文档管理    │
│ • MCP/Skills     │      │ • 工件预览       │
└──────────────────┘ └──────────────────┘关键设计决策:Agent Runtime 直接嵌入 FastAPI Gateway,而不是独立部署 LangGraph Server。这意味着更少的运维成本——一个进程同时处理 API 请求和 Agent 执行。
2.2 中间件链:8 层处理管道
每次 Agent 执行前,请求会经过 8 层中间件处理:
- ThreadDataMiddleware — 初始化工作区、上传目录、输出目录
- UploadsMiddleware — 处理用户上传的文件(文档、图片)
- SandboxMiddleware — 获取沙盒执行环境
- SummarizationMiddleware — 上下文压缩(防止 token 溢出)
- TitleMiddleware — 自动生成对话标题
- TodoListMiddleware — 任务追踪(计划模式)
- ViewImageMiddleware — 视觉模型支持(图片理解)
- ClarificationMiddleware — 处理澄清请求
这种中间件模式借鉴了 Web 框架的设计哲学,每一层职责单一、可插拔。
2.3 沙盒系统:安全执行代码
DeerFlow 的沙盒是其区别于普通聊天机器人的核心能力。提供两种模式:
| 模式 | 适用场景 | 隔离级别 |
|---|---|---|
| LocalSandbox | 本地开发、个人使用 | 进程级隔离 |
| DockerSandbox | 生产部署、多用户 | 容器级隔离 |
沙盒支持完整的文件系统操作:执行命令、读写文件、列出目录。所有操作通过虚拟路径映射实现,Agent 无法访问宿主机真实文件系统。
2.4 子代理编排:任务拆解与并行
DeerFlow 2.0 的核心创新是子代理编排系统。当面对复杂任务时,主代理(Lead Agent)会:
- 分析任务:理解任务目标和约束
- 拆解子任务:将大任务分解为可独立执行的子任务
- 分配子代理:为每个子任务创建专门的子代理
- 并行执行:多个子代理同时在各自沙盒中工作
- 汇总结果:收集所有子代理的输出,整合为最终结果
# 子代理编排伪代码
lead_agent.receive("分析 10 家竞品的定价策略并生成报告")
  → sub_agent_1: 研究竞品 A、B、C 的定价
  → sub_agent_2: 研究竞品 D、E、F 的定价
  → sub_agent_3: 研究竞品 G、H、I、J 的定价
  → sub_agent_4: 汇总数据,生成对比报告
2.5 长效记忆系统(DeerMem)
DeerFlow 的记忆系统分为两层:
- 会话记忆:当前对话的上下文,通过 LangGraph 的 Checkpoint 机制持久化
- 长效记忆:跨会话的知识积累,存储在本地文件系统,支持语义检索
长效记忆让 DeerFlow 能”记住”你之前的工作成果、偏好设置和项目背景,真正做到”越用越懂你”。
2.6 技能系统(Skills)
DeerFlow 的技能系统基于 Markdown 文件定义,每个技能包含:
- 触发条件(什么时候使用这个技能)
- 执行步骤(具体做什么)
- 工具依赖(需要哪些工具)
- 输出格式(结果如何呈现)
技能可以通过 MCP(Model Context Protocol)协议与外部服务集成,也可以完全自定义。
三、完整部署教程
3.1 环境要求
| 组件 | 最低版本 | 推荐版本 |
|---|---|---|
| Python | 3.12+ | 3.12 |
| Node.js | 22+ | 22 LTS |
| Docker | 24+ | 24+(生产部署) |
| 内存 | 8GB | 16GB+ |
| 磁盘 | 10GB | 20GB+ |
3.2 方式一:Docker 部署(推荐)
# 1. 克隆仓库
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 2. 配置环境变量
cp .env.example .env
# 编辑 .env,填入你的 LLM API Key
# 支持:OpenAI、Anthropic、Google Gemini、豆包、DeepSeek 等

# 3. 启动服务
docker compose up -d

# 4. 访问
# 前端界面:http://localhost:2026
# API 接口:http://localhost:2026/api
3.3 方式二:本地开发部署
# 1. 克隆仓库
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 2. 后端配置
cd backend
python -m venv .venv
source .venv/bin/activate
pip install -e ".[dev]"

# 复制并编辑配置
cp config.yaml.example config.yaml
# 编辑 config.yaml 配置模型 API Key

# 3. 前端配置
cd ../frontend
npm install

# 4. 启动服务
# 终端 1:启动后端
cd backend && python -m app.gateway.app

# 终端 2:启动前端
cd frontend && npm run dev

# 5. 访问 http://localhost:3000
3.4 模型配置
DeerFlow 支持多种 LLM 提供商,官方推荐:
| 模型 | 适用场景 | 备注 |
|---|---|---|
| 豆包 Seed-2.0-Code | 编码任务 | 字节自研,与 DeerFlow 深度适配 |
| DeepSeek v3.2 | 通用任务 | 性价比高,中文能力强 |
| Kimi 2.5 | 长文本处理 | 超长上下文窗口 |
| Claude 3.5 Sonnet | 复杂推理 | 英文场景首选 |
| GPT-4o | 多模态任务 | 图文混合理解 |
在 config.yaml 中配置:
models:
  default:
    provider: openai
    model: deepseek-v3.2
    api_key: ${DEEPSEEK_API_KEY}

  reasoning:
    provider: anthropic
    model: claude-3.5-sonnet
    api_key: ${ANTHROPIC_API_KEY}
3.5 沙盒配置
# config.yaml
sandbox:
  # 本地开发用 LocalSandbox
  provider: local

  # 生产部署用 DockerSandbox
  # provider: docker
  # docker:
  #   image: python:3.12-slim
  #   memory_limit: "2g"
  #   cpu_limit: "2.0"
四、实战案例:用 DeerFlow 完成竞品分析
让我们通过一个实际案例,感受 DeerFlow 2.0 的能力。
4.1 任务描述
“帮我分析 Notion、Obsidian、Logseq 这三款笔记工具的定价策略、核心功能差异和用户口碑,生成一份对比报告。“
4.2 DeerFlow 的执行过程
Step 1:任务拆解
Lead Agent 将任务拆解为 4 个子任务:
- 研究 Notion 的定价、功能、用户评价
- 研究 Obsidian 的定价、功能、用户评价
- 研究 Logseq 的定价、功能、用户评价
- 汇总对比,生成报告
Step 2:并行执行
3 个子代理同时在沙盒中启动,各自使用浏览器工具访问目标产品官网、定价页面、Reddit/G2 评价页面。
Step 3:信息整合
每个子代理将收集到的数据整理为结构化格式,存入沙盒文件系统。
Step 4:报告生成
汇总子代理调用代码执行工具,将数据渲染为 Markdown 报告 + 对比表格,输出到工件目录。
整个过程约 3-5 分钟完成,如果手动做同样的工作,至少需要 2-3 小时。
五、横向对比:DeerFlow vs AutoGPT vs CrewAI vs LangGraph
| 维度 | DeerFlow 2.0 | AutoGPT | CrewAI | LangGraph |
|---|---|---|---|---|
| 定位 | SuperAgent 引擎 | 自主 AI 代理 | 角色扮演多代理 | 状态图编排框架 |
| 架构 | 中间件链 + 子代理 | 单代理循环 | 角色协作 | 有向图状态机 |
| 沙盒 | ✅ Docker/本地 | ❌ 无原生沙盒 | ❌ 无原生沙盒 | ❌ 无沙盒 |
| 记忆 | ✅ 跨会话长效记忆 | ⚠️ 有限 | ⚠️ 有限 | ✅ Checkpoint |
| 技能扩展 | ✅ Markdown 技能 + MCP | ⚠️ 插件 | ✅ 工具定义 | ✅ 自定义节点 |
| 浏览器控制 | ✅ 内置 | ✅ 有 | ❌ 需集成 | ❌ 需集成 |
| Web UI | ✅ Next.js 精美界面 | ⚠️ 基础界面 | ❌ 无 | ⚠️ Studio |
| 部署难度 | 中等(Docker 一键) | 简单 | 简单 | 中等 |
| 适用场景 | 长程复杂任务 | 简单自主任务 | 角色分工明确 | 需要精细控制流 |
| Star 数 | 83K+ | 170K+ | 30K+ | 15K+ |
| 许可证 | MIT | MIT | MIT | MIT |
5.1 选择建议
- 选 DeerFlow 2.0:需要处理长程复杂任务、需要代码执行沙盒、需要精美 Web UI、重视数据隐私(本地部署)
- 选 AutoGPT:只需要简单的自主任务循环、快速原型验证
- 选 CrewAI:任务可以清晰拆分为多个角色、团队协作模拟
- 选 LangGraph:需要对执行流有精细控制、构建自定义 Agent 应用
六、DeerFlow 2.0 的亮点与不足
✅ 亮点
- 真正的 SuperAgent 架构:不是简单的聊天机器人,而是能编排多个子代理完成复杂任务的引擎
- 安全第一的沙盒:Docker 级隔离,代码执行不影响宿主机
- 技能系统灵活:Markdown 定义技能,门槛低、易分享
- MCP 协议支持:可连接外部工具和服务,生态开放
- 完全本地部署:数据不出本机,适合企业级隐私需求
- 精美 Web UI:Next.js 构建,交互体验一流
- 字节跳动背书:83K+ Star,社区活跃,迭代快速
⚠️ 不足
- 资源消耗较高:完整部署需要 16GB+ 内存,轻量级 VPS 跑不动
- 模型依赖:需要自备 LLM API Key,运行成本不低
- 学习曲线:配置项较多,新手上手需要时间
- 中文文档待完善:核心文档以英文为主
- 2.0 与 1.x 不兼容:升级需要完全重新部署
七、常见问题 FAQ
Q1:DeerFlow 2.0 免费吗?
是的,DeerFlow 2.0 采用 MIT 开源许可证,完全免费使用。但运行时需要 LLM API(如 DeepSeek、OpenAI 等),这些 API 调用会产生费用。
Q2:DeerFlow 可以在没有 GPU 的机器上运行吗?
可以。DeerFlow 本身不调用本地模型,而是通过 API 调用云端 LLM。因此 CPU 机器即可运行,不需要 GPU。
Q3:DeerFlow 和 ChatGPT 有什么区别?
ChatGPT 是云端对话产品,数据存储在 OpenAI 服务器。DeerFlow 是本地部署的 Agent 框架,数据完全在你自己的机器上。DeerFlow 还能执行代码、操作浏览器、管理文件——这些是 ChatGPT 做不到的。
Q4:DeerFlow 支持哪些语言模型?
支持所有主流 LLM:OpenAI GPT-4o、Anthropic Claude、Google Gemini、DeepSeek、豆包(Doubao)、Kimi、通义千问等。通过 OpenAI 兼容 API 接入。
Q5:DeerFlow 适合个人开发者还是企业?
两者都适合。个人开发者可以用 LocalSandbox 模式快速上手;企业可以用 DockerSandbox + 多用户隔离模式进行生产部署。
Q6:如何从 DeerFlow 1.x 升级到 2.0?
2.0 是完全重写,不支持直接升级。需要重新部署 2.0 版本。1.x 版本仍在 main-1.x 分支维护,但新功能开发集中在 2.0。
八、总结
DeerFlow 2.0 代表了开源 AI Agent 框架的一个重要里程碑。它不再满足于做一个”会聊天的 AI”,而是进化为一个能思考、能执行、能记忆的全天候 AI 员工。
对于开发者来说,DeerFlow 2.0 的价值在于:
- 降低 AI 应用开发门槛:不需要从零搭建 Agent 基础设施
- 提高复杂任务自动化程度:多代理编排让 AI 真正”干活”
- 保障数据安全:完全本地部署,数据不出门
如果你正在寻找一个开源、强大、可本地部署的 AI Agent 框架,DeerFlow 2.0 值得认真评估。
参考链接:
希望这篇深度解析对你有所帮助!如果你已经在使用 DeerFlow 2.0,欢迎在评论区分享你的使用体验。