DeerFlow 2.0 im Test: ByteDances Open-Source SuperAgent für 24/7 KI-Mitarbeiter im Detail
1. Was ist DeerFlow 2.0? Von Deep Research zum Super-Agenten
Im Februar 2026 veröffentlichte ByteDance offiziell DeerFlow 2.0, eine komplett neue Implementierung von Grund auf — ohne Code-Sharing mit Version 1.x, mit 182 PRs, die DeerFlow von einem “Deep-Research-Framework” zu einer vollwertigen Open-Source SuperAgent Engine transformiert haben.
DeerFlow steht für Deep Exploration and Efficient Research Flow (Tiefe Exploration und effizienter Forschungsfluss). Es hat über 83.000 Stars auf GitHub erhalten und ist eines der beliebtesten Open-Source-KI-Projekte des Jahres 2026.
1.1 Einzeilige Positionierung
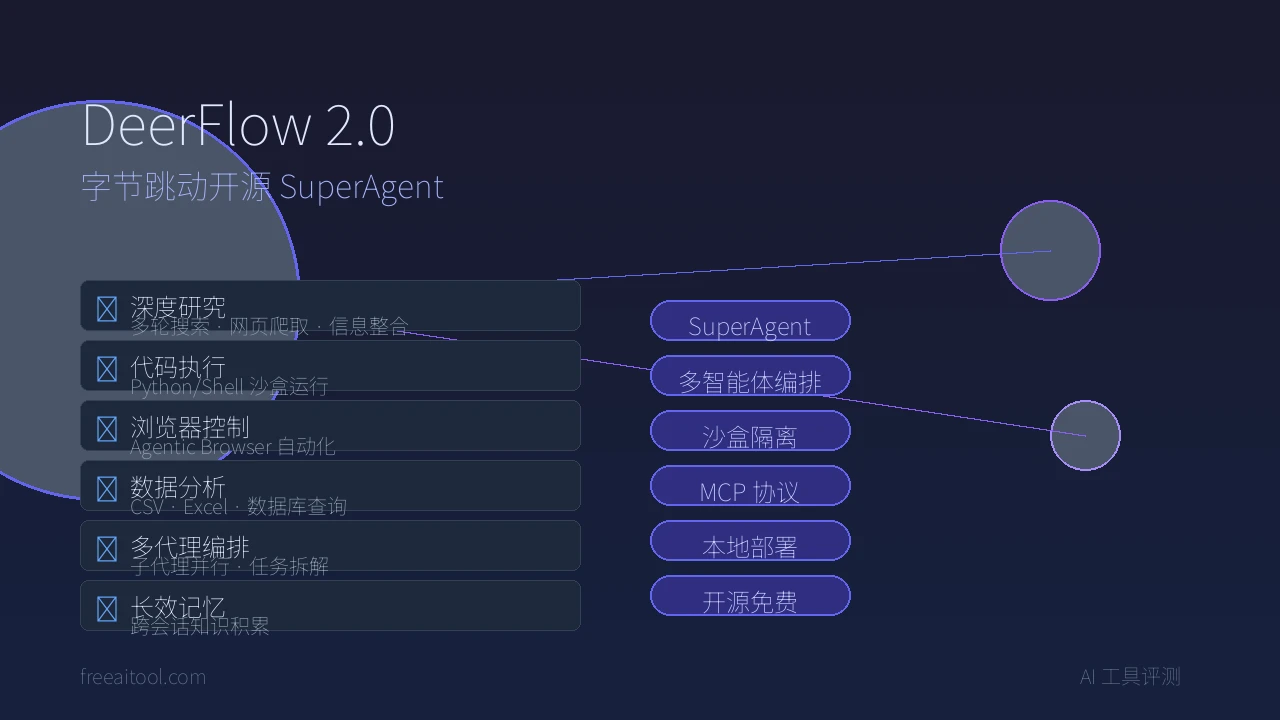
DeerFlow 2.0 ist eine Open-Source SuperAgent Harness, die Sub-Agenten orchestriert, Speicher verwaltet und Sandboxes isoliert, um nahezu jede komplexe Aufgabe durch ein erweiterbares Skill-System zu erledigen.
Im Gegensatz zu Version 1.0, die nur “Deep Research” durchführte, kann DeerFlow 2.0:
- 🔬 Deep Research: Mehrstufige Suche, Web-Crawling, Informationsintegration
- 💻 Code schreiben: Python/Shell in Sandboxes ausführen, ausführbare Programme generieren
- 🌐 Web durchsuchen: Eingebaute Agentic-Browser-Steuerung für automatisierte Web-Operationen
- 📊 Datenanalyse: CSV, Excel, Datenbankabfragen verarbeiten
- 📝 Content-Erstellung: Berichte, Präsentationen, Dokumente generieren
- 🤖 Multi-Task-Orchestrierung: Komplexe Aufgaben in parallele Sub-Agenten zerlegen
1.2 Warum ist es relevant?
| Feature | DeerFlow 2.0 | Traditionelle KI-Assistenten |
|---|---|---|
| Aufgabenkomplexität | Langfristig, mehrstufig, domänenübergreifend | Einzelne Frage-Antwort |
| Ausführungsumgebung | Isolierte Sandbox, Code-Ausführung | Nur Textgenerierung |
| Speicherfähigkeit | Sitzungsübergreifender persistenter Speicher | Kein Speicher oder kurzer Kontext |
| Tool-Erweiterung | MCP-Protokoll + benutzerdefinierte Skills | Fester Funktionsumfang |
| Multi-Agent | Sub-Agent-Orchestrierung, parallele Verarbeitung | Einzelner Agent sequenziell |
| Bereitstellung | Vollständig lokal, Daten bleiben vor Ort | Cloud-API-Abhängigkeit |
2. Kernarchitektur-Analyse
Die Architektur von DeerFlow 2.0 spiegelt ByteDances Engineering-Erfahrung mit großangelegten KI-Systemen wider. Lassen Sie uns Schicht für Schicht zerlegen.
2.1 Gesamtarchitektur: Dreischichtige Trennung
┌─────────────────────────────────────────────────────┐
│           Client (Browser / TUI-Terminal)            │
└──────────────────────┬──────────────────────────────┘
                       │
                       ▼
┌─────────────────────────────────────────────────────┐
│              Nginx Reverse Proxy (Port 2026)         │
│    /api/*  → Gateway API (8001)                      │
│    /*      → Frontend (3000)                         │
└──────────────────────┬──────────────────────────────┘
                       │
          ┌────────────┴────────────┐
          ▼                         ▼
┌──────────────────┐      ┌──────────────────┐
│  Gateway API     │      │   Frontend       │
│  (FastAPI:8001)  │      │  (Next.js:3000)  │
│                  │      │                  │
│ • Agent Runtime  │      │ • React UI       │
│ • LangGraph      │      │ • Chat-Interface │
│   kompatibel     │      │ • Projekt-Docs   │
│ • SSE-Streaming  │      │ • Artefakt-Ansicht│
│ • MCP/Skills     │      │                  │
└──────────────────┘      └──────────────────┘
Wichtige Designentscheidung: Die Agent Runtime ist direkt in das FastAPI Gateway eingebettet, anstatt als separater LangGraph Server bereitgestellt zu werden. Das bedeutet weniger Betriebsaufwand — ein Prozess verarbeitet sowohl API-Anfragen als auch Agent-Ausführung.
2.2 Middleware-Kette: 8-Schichten-Verarbeitungspipeline
Vor jeder Agent-Ausführung durchlaufen Anfragen 8 Middleware-Schichten:
- ThreadDataMiddleware — Initialisiert Workspace, Upload-Verzeichnis, Ausgabe-Verzeichnis
- UploadsMiddleware — Verarbeitet hochgeladene Dateien (Dokumente, Bilder)
- SandboxMiddleware — Ruft Sandbox-Ausführungsumgebung ab
- SummarizationMiddleware — Kontextkomprimierung (verhindert Token-Überlauf)
- TitleMiddleware — Generiert automatisch Gesprächstitel
- TodoListMiddleware — Aufgabenverfolgung (Planmodus)
- ViewImageMiddleware — Vision-Modell-Unterstützung (Bildverständnis)
- ClarificationMiddleware — Verarbeitet Klärungsanfragen
Dieses Middleware-Muster lehnt sich an die Designphilosophie von Web-Frameworks an — jede Schicht hat eine einzige Verantwortung und ist plug-in-fähig.
2.3 Sandbox-System: Sichere Code-Ausführung
DeerFlows Sandbox ist die Kernfähigkeit, die es von gewöhnlichen Chatbots unterscheidet. Zwei Modi sind verfügbar:
| Modus | Anwendungsfall | Isolationsstufe |
|---|---|---|
| LocalSandbox | Lokale Entwicklung, persönliche Nutzung | Prozess-Ebene |
| DockerSandbox | Produktionsbereitstellung, Multi-User | Container-Ebene |
Die Sandbox unterstützt vollständige Dateisystemoperationen: Befehle ausführen, Dateien lesen/schreiben, Verzeichnisse auflisten. Alle Operationen verwenden virtuelle Pfadzuordnung — Agenten können nicht auf das echte Dateisystem des Hosts zugreifen.
2.4 Sub-Agent-Orchestrierung: Aufgabenzerlegung und Parallelität
DeerFlow 2.0s Kerninnovation ist das Sub-Agent-Orchestrierungssystem. Bei komplexen Aufgaben wird der Lead Agent:
- Aufgabe analysieren: Ziele und Einschränkungen verstehen
- Teilaufgaben zerlegen: Große Aufgabe in unabhängig ausführbare Teilaufgaben aufteilen
- Sub-Agenten zuweisen: Spezialisierte Sub-Agenten für jede Teilaufgabe erstellen
- Parallel ausführen: Mehrere Sub-Agenten arbeiten gleichzeitig in ihren eigenen Sandboxes
- Ergebnisse aggregieren: Alle Sub-Agent-Ausgaben sammeln und das Endergebnis synthetisieren
# Sub-Agent-Orchestrierung Pseudocode
lead_agent.receive("Analysiere Preisstrategien von 10 Wettbewerbern und erstelle Bericht")
  → sub_agent_1: Erforsche Preise von Wettbewerbern A, B, C
  → sub_agent_2: Erforsche Preise von Wettbewerbern D, E, F
  → sub_agent_3: Erforsche Preise von Wettbewerbern G, H, I, J
  → sub_agent_4: Aggregiere Daten, generiere Vergleichsbericht
2.5 Persistenter Speicher (DeerMem)
DeerFlows Speichersystem hat zwei Ebenen:
- Sitzungsspeicher: Aktueller Gesprächskontext, persistiert über LangGraphs Checkpoint-Mechanismus
- Langzeitspeicher: Sitzungsübergreifende Wissensakkumulation, gespeichert im lokalen Dateisystem mit semantischer Abrufbarkeit
Langzeitspeicher ermöglicht es DeerFlow, sich an Ihre vorherigen Arbeitsergebnisse, Einstellungen und Projektkontext zu “erinnern” — wird mit der Nutzung wirklich klüger.
2.6 Skill-System
DeerFlows Skill-System wird über Markdown-Dateien definiert, wobei jeder Skill folgendes enthält:
- Trigger-Bedingungen (wann diesen Skill verwenden)
- Ausführungsschritte (was konkret zu tun ist)
- Tool-Abhängigkeiten (welche Tools benötigt werden)
- Ausgabeformat (wie Ergebnisse präsentiert werden)
Skills können über das MCP-Protokoll (Model Context Protocol) mit externen Diensten integriert werden oder vollständig benutzerdefiniert sein.
3. Vollständige Bereitstellungsanleitung
3.1 Umgebungsanforderungen
| Komponente | Minimum | Empfohlen |
|---|---|---|
| Python | 3.12+ | 3.12 |
| Node.js | 22+ | 22 LTS |
| Docker | 24+ | 24+ (Produktion) |
| RAM | 8GB | 16GB+ |
| Festplatte | 10GB | 20GB+ |
3.2 Methode 1: Docker-Bereitstellung (empfohlen)
# 1. Repository klonen
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 2. Umgebungsvariablen konfigurieren
cp .env.example .env
# .env mit Ihrem LLM-API-Schlüssel bearbeiten
# Unterstützt: OpenAI, Anthropic, Google Gemini, Doubao, DeepSeek, etc.

# 3. Dienste starten
docker compose up -d

# 4. Zugriff
# Frontend: http://localhost:2026
# API: http://localhost:2026/api
3.3 Methode 2: Lokale Entwicklungsbereitstellung
# 1. Repository klonen
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 2. Backend-Setup
cd backend
python -m venv .venv
source .venv/bin/activate
pip install -e ".[dev]"

# Konfiguration kopieren und bearbeiten
cp config.yaml.example config.yaml
# config.yaml bearbeiten, um Modell-API-Schlüssel zu konfigurieren

# 3. Frontend-Setup
cd ../frontend
npm install

# 4. Dienste starten
# Terminal 1: Backend starten
cd backend && python -m app.gateway.app

# Terminal 2: Frontend starten
cd frontend && npm run dev

# 5. Zugriff auf http://localhost:3000
3.4 Modellkonfiguration
DeerFlow unterstützt mehrere LLM-Anbieter. Offizielle Empfehlungen:
| Modell | Anwendungsfall | Hinweise |
|---|---|---|
| Doubao Seed-2.0-Code | Codierungsaufgaben | ByteDances eigenes, tief integriert mit DeerFlow |
| DeepSeek v3.2 | Allgemeine Aufgaben | Großartiges Preis-Leistungs-Verhältnis, starkes Chinesisch |
| Kimi 2.5 | Langtextverarbeitung | Ultra-langes Kontextfenster |
| Claude 3.5 Sonnet | Komplexe Argumentation | Erste Wahl für englische Szenarien |
| GPT-4o | Multimodale Aufgaben | Gemischtes Bild-Text-Verständnis |
Konfigurieren in config.yaml:
models:
  default:
    provider: openai
    model: deepseek-v3.2
    api_key: ${DEEPSEEK_API_KEY}

  reasoning:
    provider: anthropic
    model: claude-3.5-sonnet
    api_key: ${ANTHROPIC_API_KEY}
3.5 Sandbox-Konfiguration
# config.yaml
sandbox:
  # LocalSandbox für lokale Entwicklung verwenden
  provider: local

  # DockerSandbox für Produktion verwenden
  # provider: docker
  # docker:
  #   image: python:3.12-slim
  #   memory_limit: "2g"
  #   cpu_limit: "2.0"
4. Praxisfall: Wettbewerbsanalyse mit DeerFlow
Lassen Sie uns durch einen realen Fall DeerFlow 2.0s Fähigkeiten erleben.
4.1 Aufgabenbeschreibung
“Hilf mir, die Preisstrategien, Kernfunktionsunterschiede und Nutzerstimmungen von Notion, Obsidian und Logseq zu analysieren. Erstelle einen Vergleichsbericht.”
4.2 DeerFlows Ausführungsprozess
Schritt 1: Aufgabenzerlegung
Der Lead Agent zerlegt die Aufgabe in 4 Teilaufgaben:
- Notions Preise, Funktionen und Nutzerbewertungen erforschen
- Obsidians Preise, Funktionen und Nutzerbewertungen erforschen
- Logseqs Preise, Funktionen und Nutzerbewertungen erforschen
- Aggregieren und Bericht generieren
Schritt 2: Parallele Ausführung
3 Sub-Agenten starten gleichzeitig in Sandboxes, jeder verwendet Browser-Tools, um die Zielprodukt-Website, Preisseiten und Reddit/G2-Bewertungsseiten zu besuchen.
Schritt 3: Informationsaggregation
Jeder Sub-Agent organisiert gesammelte Daten in strukturierter Form und speichert sie im Sandbox-Dateisystem.
Schritt 4: Berichtsgenerierung
Der Aggregations-Sub-Agent verwendet Code-Ausführungstools, um die Daten als Markdown-Bericht + Vergleichstabellen zu rendern, Ausgabe ins Artefakt-Verzeichnis.
Der gesamte Prozess dauert etwa 3-5 Minuten — die gleiche Arbeit manuell durchzuführen würde mindestens 2-3 Stunden dauern.
5. Vergleich: DeerFlow vs AutoGPT vs CrewAI vs LangGraph
| Dimension | DeerFlow 2.0 | AutoGPT | CrewAI | LangGraph |
|---|---|---|---|---|
| Positionierung | SuperAgent Engine | Autonomer KI-Agent | Rollenbasierte Multi-Agenten | Zustandsgraph-Framework |
| Architektur | Middleware-Kette + Sub-Agenten | Einzelner Agent-Loop | Rollenzusammenarbeit | Gerichteter Graph-Zustandsautomat |
| Sandbox | ✅ Docker/Lokal | ❌ Keine native Sandbox | ❌ Keine native Sandbox | ❌ Keine Sandbox |
| Speicher | ✅ Sitzungsübergreifend persistent | ⚠️ Begrenzt | ⚠️ Begrenzt | ✅ Checkpoint |
| Skill-Erweiterung | ✅ Markdown-Skills + MCP | ⚠️ Plugins | ✅ Tool-Definitionen | ✅ Benutzerdefinierte Knoten |
| Browser-Steuerung | ✅ Eingebaut | ✅ Verfügbar | ❌ Erfordert Integration | ❌ Erfordert Integration |
| Web-UI | ✅ Schöne Next.js-Oberfläche | ⚠️ Basis-UI | ❌ Keine | ⚠️ Studio |
| Bereitstellungsschwierigkeit | Mittel (One-Click-Docker) | Einfach | Einfach | Mittel |
| Anwendungsfall | Langfristige komplexe Aufgaben | Einfache autonome Aufgaben | Klare Rollenteilung | Feingranulare Steuerung |
| Stars | 83K+ | 170K+ | 30K+ | 15K+ |
| Lizenz | MIT | MIT | MIT | MIT |
5.1 Auswahlhilfe
- DeerFlow 2.0 wählen: Langfristige komplexe Aufgaben benötigt, Code-Ausführungs-Sandbox, schöne Web-UI, Datenprivatsphäre (lokale Bereitstellung)
- AutoGPT wählen: Nur einfache autonome Aufgabenloops, schnelles Prototyping
- CrewAI wählen: Aufgaben können klar in mehrere Rollen aufgeteilt werden, Teamzusammenarbeits-Simulation
- LangGraph wählen: Feingranulare Kontrolle über Ausführungsfluss benötigt, benutzerdefinierte Agent-Anwendungen erstellen
6. Highlights und Mängel von DeerFlow 2.0
✅ Highlights
- Echte SuperAgent-Architektur: Nicht nur ein Chatbot — eine Engine, die mehrere Sub-Agenten für komplexe Aufgaben orchestriert
- Sicherheitsfirst-Sandbox: Docker-Level-Isolation, Code-Ausführung beeinflusst den Host nicht
- Flexibles Skill-System: Markdown-definierte Skills, niedrige Einstiegshürde, einfach zu teilen
- MCP-Protokoll-Unterstützung: Kann mit externen Tools und Diensten verbinden, offenes Ökosystem
- Vollständig lokale Bereitstellung: Daten verlassen nie Ihre Maschine, geeignet für Enterprise-Datenschutz
- Schöne Web-UI: Mit Next.js gebaut, erstklassige Interaktionserfahrung
- ByteDance-Backing: 83K+ Stars, aktive Community, schnelle Iteration
⚠️ Mängel
- Hoher Ressourcenverbrauch: Vollständige Bereitstellung erfordert 16GB+ RAM, läuft nicht auf leichtgewichtigen VPS
- Modellabhängigkeit: Erfordert eigenen LLM-API-Schlüssel, Betriebskosten sind nicht trivial
- Lernkurve: Viele Konfigurationsoptionen, Anfänger brauchen Zeit zum Einstieg
- Dokumentation verbesserungswürdig: Kerndokumentation hauptsächlich auf Englisch
- 2.0 inkompatibel mit 1.x: Upgrade erfordert komplette Neubereitstellung
7. Häufig gestellte Fragen
F1: Ist DeerFlow 2.0 kostenlos?
Ja, DeerFlow 2.0 verwendet die MIT-Open-Source-Lizenz und ist komplett kostenlos nutzbar. Allerdings erfordert die Ausführung LLM-APIs (wie DeepSeek, OpenAI, etc.), die API-Aufrufkosten verursachen.
F2: Kann DeerFlow auf Maschinen ohne GPU laufen?
Ja. DeerFlow selbst ruft keine lokalen Modelle auf — es ruft Cloud-LLMs über API auf. Daher reicht eine CPU-Maschine aus, keine GPU erforderlich.
F3: Was ist der Unterschied zwischen DeerFlow und ChatGPT?
ChatGPT ist ein cloudbasiertes Konversationsprodukt mit Daten auf OpenAIs Servern. DeerFlow ist ein lokal bereitgestelltes Agent-Framework mit Daten vollständig auf Ihrer Maschine. DeerFlow kann auch Code ausführen, Browser bedienen und Dateien verwalten — Dinge, die ChatGPT nicht kann.
F4: Welche Sprachmodelle unterstützt DeerFlow?
Alle wichtigen LLMs: OpenAI GPT-4o, Anthropic Claude, Google Gemini, DeepSeek, Doubao, Kimi, Qwen, etc. Verbunden über OpenAI-kompatible APIs.
F5: Ist DeerFlow für einzelne Entwickler oder Unternehmen geeignet?
Beides. Einzelne Entwickler können den LocalSandbox-Modus für schnellen Einstieg nutzen; Unternehmen können DockerSandbox + Multi-User-Isolation für Produktionsbereitstellung verwenden.
F6: Wie von DeerFlow 1.x auf 2.0 upgraden?
2.0 ist eine komplette Neuimplementierung — direktes Upgrade wird nicht unterstützt. Sie müssen Version 2.0 neu bereitstellen. Version 1.x wird weiterhin auf dem main-1.x-Branch gewartet, aber neue Funktionsentwicklung konzentriert sich auf 2.0.
8. Fazit
DeerFlow 2.0 repräsentiert einen wichtigen Meilenstein in Open-Source-KI-Agent-Frameworks. Es ist nicht länger damit zufrieden, ein “redender KI” zu sein — es hat sich zu einem denkenden, ausführenden, sich erinnernden 24/7-KI-Mitarbeiter entwickelt.
Für Entwickler liegt DeerFlow 2.0s Wert in:
- Senkung der KI-Anwendungsentwicklungshürden: Keine Notwendigkeit, Agent-Infrastruktur von Grund auf zu bauen
- Erhöhung der Automatisierung komplexer Aufgaben: Multi-Agent-Orchestrierung lässt KI wirklich “Arbeit erledigen”
- Gewährleistung der Datensicherheit: Vollständig lokale Bereitstellung, Daten verlassen nie Ihre Räumlichkeiten
Wenn Sie nach einem Open-Source, leistungsstarken, lokal bereitstellbaren KI-Agent-Framework suchen, verdient DeerFlow 2.0 ernsthafte Bewertung.
Referenzlinks:
- DeerFlow GitHub-Repository
- DeerFlow Offizielle Website
- DeerFlow Architektur-Dokumentation
- ByteDance Coding Plan
Hoffentlich war diese Tiefenanalyse hilfreich! Wenn Sie bereits DeerFlow 2.0 nutzen, teilen Sie gerne Ihre Erfahrung in den Kommentaren.