DeerFlow 2.0 實測:字節跳動開源 SuperAgent,全天候 AI 員工深度解析
一、DeerFlow 2.0 是什麼?從深度研究到超級智能體的進化
2026 年 2 月,字節跳動正式發布了 DeerFlow 2.0,這是一次從零開始的重寫——與 1.x 版本不共享任何代碼,匯聚了 182 個 PR,將 DeerFlow 從一個「深度研究框架」徹底進化爲開源 SuperAgent 引擎。
DeerFlow 的全稱是 Deep Exploration and Efficient Research Flow(深度探索與高效研究流)。在 GitHub 上已經斬獲超過 83,000 Stars,成爲 2026 年最熱門的開源 AI 項目之一。
1.1 一句話定位
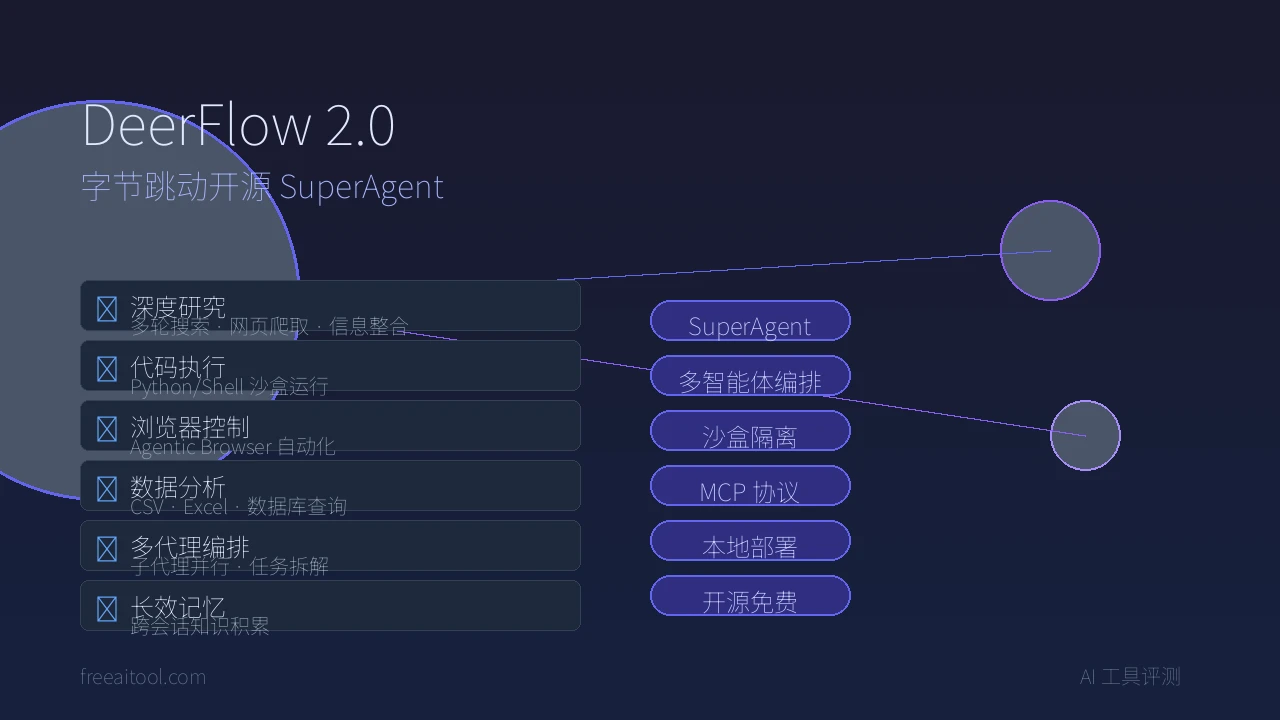
DeerFlow 2.0 是一個開源的超級智能體調度框架(SuperAgent Harness),它能編排子代理、管理記憶、隔離沙盒,通過可擴展的技能系統完成幾乎任何複雜任務。
與 1.0 版本只做「深度研究」不同,2.0 版本的 DeerFlow 可以:
- 🔬 深度研究:多輪搜索、網頁爬取、信息整合
- 💻 編寫代碼:在沙盒中執行 Python/Shell,生成可運行程序
- 🌐 瀏覽網頁:內置 Agentic Browser 控制,自動操作網頁
- 📊 數據分析:處理 CSV、Excel、數據庫查詢
- 📝 內容創作:生成報告、PPT、文檔
- 🤖 多任務編排:將複雜任務拆解爲多個子代理並行執行
1.2 爲什麼值得關注?
| 特性 | DeerFlow 2.0 | 傳統 AI 助手 |
|---|---|---|
| 任務複雜度 | 長程、多步驟、跨領域 | 單輪問答 |
| 執行環境 | 隔離沙盒,可執行代碼 | 純文本生成 |
| 記憶能力 | 跨會話長效記憶 | 無記憶或短期上下文 |
| 工具擴展 | MCP 協議 + 自定義技能 | 固定功能集 |
| 多代理 | 子代理編排,並行處理 | 單代理串行 |
| 部署方式 | 完全本地,數據不出門 | 雲端 API 依賴 |
二、核心技術架構解析
DeerFlow 2.0 的架構設計體現了字節跳動在大規模 AI 系統上的工程經驗。我們逐層拆解。
2.1 整體架構:三層分離
┌─────────────────────────────────────────────────────┐
│           Client(瀏覽器 / TUI 終端)                  │
└──────────────────────┬──────────────────────────────┘
                       │
                       ▼
┌─────────────────────────────────────────────────────┐
│              Nginx 反向代理(端口 2026)               │
│    /api/*  → Gateway API (8001)                      │
│    /*      → Frontend (3000)                         │
└──────────────────────┬──────────────────────────────┘
                       │
          ┌────────────┴────────────┐
          ▼                         ▼
┌──────────────────┐      ┌──────────────────┐
│  Gateway API     │      │   Frontend       │
│  (FastAPI:8001)  │      │  (Next.js:3000)  │
│                  │      │                  │
│ • Agent Runtime  │      │ • React UI       │
│ • LangGraph 兼容 │      │ • 聊天界面        │
│ • SSE 流式響應   │      │ • 項目文檔管理    │
│ • MCP/Skills     │      │ • 工件預覽       │
└──────────────────┘ └──────────────────┘關鍵設計決策:Agent Runtime 直接嵌入 FastAPI Gateway,而不是獨立部署 LangGraph Server。這意味着更少的運維成本——一個進程同時處理 API 請求和 Agent 執行。
2.2 中間件鏈:8 層處理管道
每次 Agent 執行前,請求會經過 8 層中間件處理:
- ThreadDataMiddleware — 初始化工作區、上傳目錄、輸出目錄
- UploadsMiddleware — 處理用戶上傳的文件(文檔、圖片)
- SandboxMiddleware — 獲取沙盒執行環境
- SummarizationMiddleware — 上下文壓縮(防止 token 溢出)
- TitleMiddleware — 自動生成對話標題
- TodoListMiddleware — 任務追蹤(計劃模式)
- ViewImageMiddleware — 視覺模型支持(圖片理解)
- ClarificationMiddleware — 處理澄清請求
這種中間件模式借鑑了 Web 框架的設計哲學,每一層職責單一、可插拔。
2.3 沙盒系統:安全執行代碼
DeerFlow 的沙盒是其區別於普通聊天機器人的核心能力。提供兩種模式:
| 模式 | 適用場景 | 隔離級別 |
|---|---|---|
| LocalSandbox | 本地開發、個人使用 | 進程級隔離 |
| DockerSandbox | 生產部署、多用戶 | 容器級隔離 |
沙盒支持完整的文件系統操作:執行命令、讀寫文件、列出目錄。所有操作通過虛擬路徑映射實現,Agent 無法訪問宿主機真實文件系統。
2.4 子代理編排:任務拆解與並行
DeerFlow 2.0 的核心創新是子代理編排系統。當面對複雜任務時,主代理(Lead Agent)會:
- 分析任務:理解任務目標和約束
- 拆解子任務:將大任務分解爲可獨立執行的子任務
- 分配子代理:爲每個子任務創建專門的子代理
- 並行執行:多個子代理同時在各自沙盒中工作
- 彙總結果:收集所有子代理的輸出,整合爲最終結果
# 子代理編排僞代碼
lead_agent.receive("分析 10 家競品的定價策略並生成報告")
  → sub_agent_1: 研究競品 A、B、C 的定價
  → sub_agent_2: 研究競品 D、E、F 的定價
  → sub_agent_3: 研究競品 G、H、I、J 的定價
  → sub_agent_4: 彙總數據,生成對比報告
2.5 長效記憶系統(DeerMem)
DeerFlow 的記憶系統分爲兩層:
- 會話記憶:當前對話的上下文,通過 LangGraph 的 Checkpoint 機制持久化
- 長效記憶:跨會話的知識積累,存儲在本地文件系統,支持語義檢索
長效記憶讓 DeerFlow 能「記住」你之前的工作成果、偏好設置和項目背景,真正做到「越用越懂你」。
2.6 技能系統(Skills)
DeerFlow 的技能系統基於 Markdown 文件定義,每個技能包含:
- 觸發條件(什麼時候使用這個技能)
- 執行步驟(具體做什麼)
- 工具依賴(需要哪些工具)
- 輸出格式(結果如何呈現)
技能可以通過 MCP(Model Context Protocol)協議與外部服務集成,也可以完全自定義。
三、完整部署教程
3.1 環境要求
| 組件 | 最低版本 | 推薦版本 |
|---|---|---|
| Python | 3.12+ | 3.12 |
| Node.js | 22+ | 22 LTS |
| Docker | 24+ | 24+(生產部署) |
| 內存 | 8GB | 16GB+ |
| 磁盤 | 10GB | 20GB+ |
3.2 方式一:Docker 部署(推薦)
# 1. 克隆倉庫
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 2. 配置環境變量
cp .env.example .env
# 編輯 .env,填入你的 LLM API Key
# 支持:OpenAI、Anthropic、Google Gemini、豆包、DeepSeek 等

# 3. 啓動服務
docker compose up -d

# 4. 訪問
# 前端界面:http://localhost:2026
# API 接口:http://localhost:2026/api
3.3 方式二:本地開發部署
# 1. 克隆倉庫
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 2. 後端配置
cd backend
python -m venv .venv
source .venv/bin/activate
pip install -e ".[dev]"

# 複製並編輯配置
cp config.yaml.example config.yaml
# 編輯 config.yaml 配置模型 API Key

# 3. 前端配置
cd ../frontend
npm install

# 4. 啓動服務
# 終端 1:啓動後端
cd backend && python -m app.gateway.app

# 終端 2:啓動前端
cd frontend && npm run dev

# 5. 訪問 http://localhost:3000
3.4 模型配置
DeerFlow 支持多種 LLM 提供商,官方推薦:
| 模型 | 適用場景 | 備註 |
|---|---|---|
| 豆包 Seed-2.0-Code | 編碼任務 | 字節自研,與 DeerFlow 深度適配 |
| DeepSeek v3.2 | 通用任務 | 性價比高,中文能力強 |
| Kimi 2.5 | 長文本處理 | 超長上下文窗口 |
| Claude 3.5 Sonnet | 複雜推理 | 英文場景首選 |
| GPT-4o | 多模態任務 | 圖文混合理解 |
在 config.yaml 中配置:
models:
  default:
    provider: openai
    model: deepseek-v3.2
    api_key: ${DEEPSEEK_API_KEY}

  reasoning:
    provider: anthropic
    model: claude-3.5-sonnet
    api_key: ${ANTHROPIC_API_KEY}
3.5 沙盒配置
# config.yaml
sandbox:
  # 本地開發用 LocalSandbox
  provider: local

  # 生產部署用 DockerSandbox
  # provider: docker
  # docker:
  #   image: python:3.12-slim
  #   memory_limit: "2g"
  #   cpu_limit: "2.0"
四、實戰案例:用 DeerFlow 完成競品分析
讓我們通過一個實際案例,感受 DeerFlow 2.0 的能力。
4.1 任務描述
“幫我分析 Notion、Obsidian、Logseq 這三款筆記工具的定價策略、核心功能差異和用戶口碑,生成一份對比報告。“
4.2 DeerFlow 的執行過程
Step 1:任務拆解
Lead Agent 將任務拆解爲 4 個子任務:
- 研究 Notion 的定價、功能、用戶評價
- 研究 Obsidian 的定價、功能、用戶評價
- 研究 Logseq 的定價、功能、用戶評價
- 彙總對比,生成報告
Step 2:並行執行
3 個子代理同時在沙盒中啓動,各自使用瀏覽器工具訪問目標產品官網、定價頁面、Reddit/G2 評價頁面。
Step 3:信息整合
每個子代理將收集到的數據整理爲結構化格式,存入沙盒文件系統。
Step 4:報告生成
彙總子代理調用代碼執行工具,將數據渲染爲 Markdown 報告 + 對比表格,輸出到工件目錄。
整個過程約 3-5 分鐘完成,如果手動做同樣的工作,至少需要 2-3 小時。
五、橫向對比:DeerFlow vs AutoGPT vs CrewAI vs LangGraph
| 維度 | DeerFlow 2.0 | AutoGPT | CrewAI | LangGraph |
|---|---|---|---|---|
| 定位 | SuperAgent 引擎 | 自主 AI 代理 | 角色扮演多代理 | 狀態圖編排框架 |
| 架構 | 中間件鏈 + 子代理 | 單代理循環 | 角色協作 | 有向圖狀態機 |
| 沙盒 | ✅ Docker/本地 | ❌ 無原生沙盒 | ❌ 無原生沙盒 | ❌ 無沙盒 |
| 記憶 | ✅ 跨會話長效記憶 | ⚠️ 有限 | ⚠️ 有限 | ✅ Checkpoint |
| 技能擴展 | ✅ Markdown 技能 + MCP | ⚠️ 插件 | ✅ 工具定義 | ✅ 自定義節點 |
| 瀏覽器控制 | ✅ 內置 | ✅ 有 | ❌ 需集成 | ❌ 需集成 |
| Web UI | ✅ Next.js 精美界面 | ⚠️ 基礎界面 | ❌ 無 | ⚠️ Studio |
| 部署難度 | 中等(Docker 一鍵) | 簡單 | 簡單 | 中等 |
| 適用場景 | 長程複雜任務 | 簡單自主任務 | 角色分工明確 | 需要精細控制流 |
| Star 數 | 83K+ | 170K+ | 30K+ | 15K+ |
| 許可證 | MIT | MIT | MIT | MIT |
5.1 選擇建議
- 選 DeerFlow 2.0:需要處理長程複雜任務、需要代碼執行沙盒、需要精美 Web UI、重視數據隱私(本地部署)
- 選 AutoGPT:只需要簡單的自主任務循環、快速原型驗證
- 選 CrewAI:任務可以清晰拆分爲多個角色、團隊協作模擬
- 選 LangGraph:需要對執行流有精細控制、構建自定義 Agent 應用
六、DeerFlow 2.0 的亮點與不足
✅ 亮點
- 真正的 SuperAgent 架構:不是簡單的聊天機器人,而是能編排多個子代理完成複雜任務的引擎
- 安全第一的沙盒:Docker 級隔離,代碼執行不影響宿主機
- 技能系統靈活:Markdown 定義技能,門檻低、易分享
- MCP 協議支持:可連接外部工具和服務,生態開放
- 完全本地部署:數據不出本機,適合企業級隱私需求
- 精美 Web UI:Next.js 構建,交互體驗一流
- 字節跳動背書:83K+ Star,社區活躍,迭代快速
⚠️ 不足
- 資源消耗較高:完整部署需要 16GB+ 內存,輕量級 VPS 跑不動
- 模型依賴:需要自備 LLM API Key,運行成本不低
- 學習曲線:配置項較多,新手上手需要時間
- 中文文檔待完善:核心文檔以英文爲主
- 2.0 與 1.x 不兼容:升級需要完全重新部署
七、常見問題 FAQ
Q1:DeerFlow 2.0 免費嗎?
是的,DeerFlow 2.0 採用 MIT 開源許可證,完全免費使用。但運行時需要 LLM API(如 DeepSeek、OpenAI 等),這些 API 調用會產生費用。
Q2:DeerFlow 可以在沒有 GPU 的機器上運行嗎?
可以。DeerFlow 本身不調用本地模型,而是通過 API 調用雲端 LLM。因此 CPU 機器即可運行,不需要 GPU。
Q3:DeerFlow 和 ChatGPT 有什麼區別?
ChatGPT 是雲端對話產品,數據存儲在 OpenAI 服務器。DeerFlow 是本地部署的 Agent 框架,數據完全在你自己的機器上。DeerFlow 還能執行代碼、操作瀏覽器、管理文件——這些是 ChatGPT 做不到的。
Q4:DeerFlow 支持哪些語言模型?
支持所有主流 LLM:OpenAI GPT-4o、Anthropic Claude、Google Gemini、DeepSeek、豆包(Doubao)、Kimi、通義千問等。通過 OpenAI 兼容 API 接入。
Q5:DeerFlow 適合個人開發者還是企業?
兩者都適合。個人開發者可以用 LocalSandbox 模式快速上手;企業可以用 DockerSandbox + 多用戶隔離模式進行生產部署。
Q6:如何從 DeerFlow 1.x 升級到 2.0?
2.0 是完全重写,不支持直接升級。需要重新部署 2.0 版本。1.x 版本仍在 main-1.x 分支維護,但新功能開發集中在 2.0。
八、總結
DeerFlow 2.0 代表了開源 AI Agent 框架的一個重要里程碑。它不再滿足於做一個「會聊天的 AI」,而是進化爲一個能思考、能執行、能記憶的全天候 AI 員工。
對於開發者來說,DeerFlow 2.0 的價值在於:
- 降低 AI 應用開發門檻:不需要從零搭建 Agent 基礎設施
- 提高複雜任務自動化程度:多代理編排讓 AI 真正「幹活」
- 保障數據安全:完全本地部署,數據不出門
如果你正在尋找一個開源、強大、可本地部署的 AI Agent 框架,DeerFlow 2.0 值得認真評估。
參考鏈接:
希望這篇深度解析對你有所幫助!如果你已經在使用 DeerFlow 2.0,歡迎在評論區分享你的使用體驗。