DeerFlow 2.0 Testé : Le SuperAgent Open-Source de ByteDance pour un IA Employé 24/7
1. Qu’est-ce que DeerFlow 2.0 ? De la Recherche Approfondie au Super Agent
En février 2026, ByteDance a officiellement publié DeerFlow 2.0, une réécriture complète depuis zéro — sans partage de code avec la version 1.x, avec 182 PR intégrés, transformant DeerFlow d’un “framework de recherche approfondie” en un véritable moteur SuperAgent open-source.
DeerFlow signifie Deep Exploration and Efficient Research Flow (Exploration approfondie et flux de recherche efficace). Il a recueilli plus de 83 000 étoiles sur GitHub, devenant l’un des projets open-source IA les plus populaires de 2026.
1.1 Positionnement en une phrase
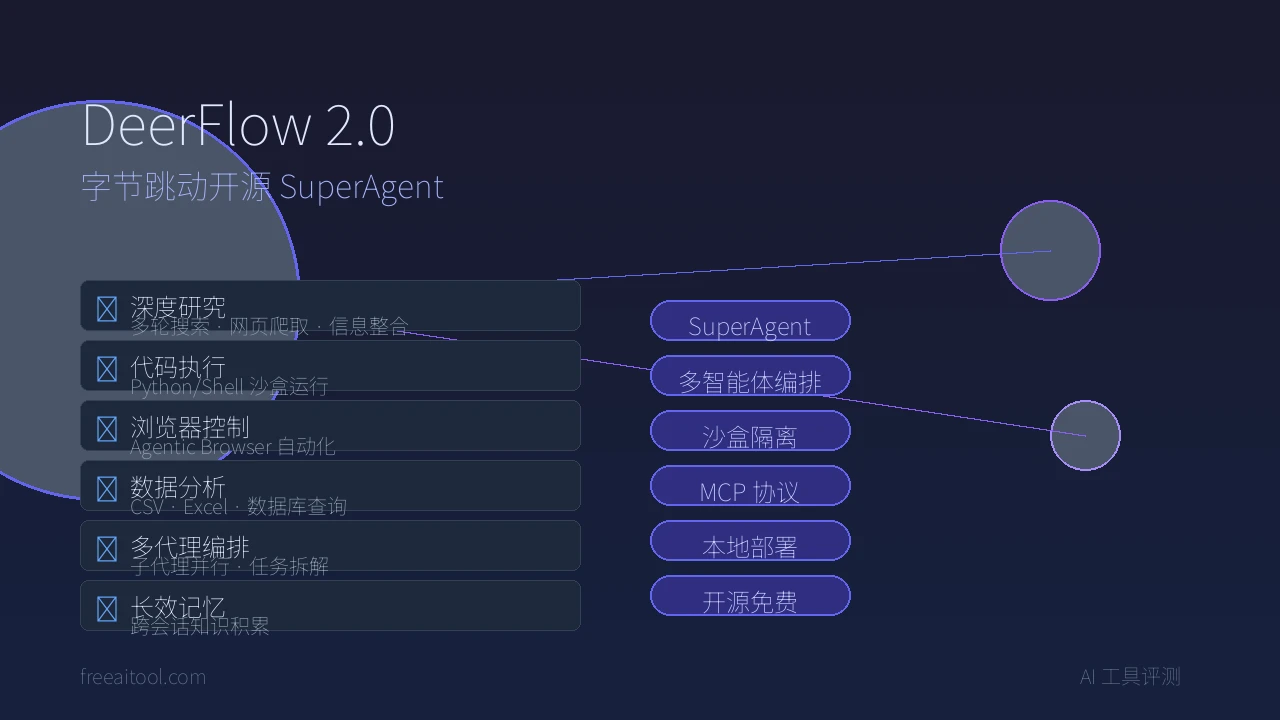
DeerFlow 2.0 est un harnais SuperAgent open-source qui orchestre des sous-agents, gère la mémoire et isole des sandbox pour accomplir pratiquement n’importe quelle tâche complexe grâce à un système de compétences extensible.
À l’inverse de la version 1.0 qui ne faisait que de la “recherche approfondie”, la version 2.0 de DeerFlow peut :
- 🔬 Recherche approfondie : Recherche multi-tours, exploration web, synthèse d’informations
- 💻 Écriture de code : Exécution de Python/Shell dans des sandbox, génération de programmes exécutables
- 🌐 Navigation web : Contrôle intégré du navigateur agent pour automatiser les opérations web
- 📊 Analyse de données : Traitement de CSV, Excel, requêtes de bases de données
- 📝 Création de contenu : Génération de rapports, présentations, documents
- 🤖 Orchestration multi-tâches : Décomposition de tâches complexes en plusieurs sous-agents exécutés en parallèle
1.2 Pourquoi cela vaut-il la peine d’être suivi ?
| Caractéristique | DeerFlow 2.0 | Assistants IA traditionnels |
|---|---|---|
| Complexité des tâches | Long terme, multi-étapes, trans-domaines | Question-réponse à un seul tour |
| Environnement d’exécution | Sandbox isolé, exécution de code | Génération de texte uniquement |
| Capacité de mémoire | Mémoire persistante intersessions | Aucune mémoire ou contexte court terme |
| Extension des outils | Protocole MCP + compétences personnalisées | Ensemble de fonctionnalités fixe |
| Multi-agents | Orchestration de sous-agents, traitement parallèle | Agent unique séquentiel |
| Déploiement | Complètement local, données restent sur site | Dépendance aux API cloud |
2. Analyse de l’architecture technique principale
L’architecture de DeerFlow 2.0 reflète l’expérience d’ingénierie de ByteDance avec des systèmes d’IA à grande échelle. Décomposons-la couche par couche.
2.1 Architecture globale : séparation en trois couches
┌─────────────────────────────────────────────────────┐
│           Client (Navigateur / Terminal TUI)         │
└──────────────────────┬──────────────────────────────┘
                       │
                       ▼
┌─────────────────────────────────────────────────────┐
│              Nginx Proxy Inverse (Port 2026)         │
│    /api/*  → API Gateway (8001)                      │
│    /*      → Frontend (3000)                         │
└──────────────────────┬──────────────────────────────┘
                       │
          ┌────────────┴────────────┐
          ▼                         ▼
┌──────────────────┐      ┌──────────────────┐
│  API Gateway     │      │   Frontend       │
│  (FastAPI:8001)  │      │  (Next.js:3000)  │
│                  │      │                  │
│ • Runtime Agent  │      │ • UI React       │
│ • LangGraph      │      │ • Interface Chat │
│   Compatible     │      │ • Gestion Docs   │
│ • Streaming SSE  │      │ • Visualisation  │
│ • MCP/Skills     │      │ • des Artefacts  │
└──────────────────┘      └──────────────────┘
Décision de conception clé : Le Runtime Agent est directement intégré dans le FastAPI Gateway plutôt que déployé en tant que serveur LangGraph séparé. Cela signifie moins de frais de fonctionnement — un seul processus traite à la fois les requêtes API et l’exécution des agents.
2.2 Chaîne de middleware : pipeline de traitement à 8 couches
Avant chaque exécution d’agent, les requêtes passent par 8 couches de middleware :
- ThreadDataMiddleware — Initialise l’espace de travail, le répertoire d’upload, le répertoire de sortie
- UploadsMiddleware — Traite les fichiers uploadés (documents, images)
- SandboxMiddleware — Acquiert l’environnement d’exécution de la sandbox
- SummarizationMiddleware — Compression de contexte (empêche le débordement de tokens)
- TitleMiddleware — Génère automatiquement les titres de conversation
- TodoListMiddleware — Suivi des tâches (mode plan)
- ViewImageMiddleware — Support du modèle de vision (compréhension d’image)
- ClarificationMiddleware — Traite les demandes de clarification
Ce modèle de middleware s’inspire de la philosophie de conception des frameworks web — chaque couche a une responsabilité unique et est enfichable.
2.3 Système de sandbox : exécution sécurisée de code
La sandbox de DeerFlow est la capacité principale qui le différencie des chatbots ordinaires. Deux modes sont disponibles :
| Mode | Cas d’utilisation | Niveau d’isolation |
|---|---|---|
| LocalSandbox | Développement local, utilisation personnelle | Isolation au niveau du processus |
| DockerSandbox | Déploiement en production, multi-utilisateur | Isolation au niveau du conteneur |
La sandbox prend en charge des opérations complètes sur le système de fichiers : exécution de commandes, lecture/écriture de fichiers, liste de répertoires. Toutes les opérations utilisent une mapping de chemins virtuels — les agents ne peuvent pas accéder au véritable système de fichiers de la machine hôte.
2.4 Orchestration de sous-agents : décomposition de tâches et parallélisme
L’innovation centrale de DeerFlow 2.0 est le système d’orchestration de sous-agents. Lorsqu’il est confronté à des tâches complexes, l’agent principal (Lead Agent) :
- Analyse la tâche : Comprend les objectifs et les contraintes
- Décompose les sous-tâches : Divise la grande tâche en sous-tâches pouvant être exécutées indépendamment
- Attribue des sous-agents : Crée des sous-agents spécialisés pour chaque sous-tâche
- Exécute en parallèle : Plusieurs sous-agents travaillent simultanément dans leurs propres sandbox
- Agrège les résultats : Rassemble toutes les sorties des sous-agents et les synthétise en résultat final
# Pseudocode d'orchestration de sous-agents
lead_agent.receive("Analyser les stratégies de prix de 10 concurrents et générer un rapport")
  → sub_agent_1 : Recherche des prix des concurrents A, B, C
  → sub_agent_2 : Recherche des prix des concurrents D, E, F
  → sub_agent_3 : Recherche des prix des concurrents G, H, I, J
  → sub_agent_4 : Agrège les données, génère un rapport comparatif
2.5 Système de mémoire persistante (DeerMem)
Le système de mémoire de DeerFlow comporte deux niveaux :
- Mémoire de session : Contexte de la conversation actuelle, persistant via le mécanisme de Checkpoint de LangGraph
- Mémoire à long terme : Accumulation de connaissances intersessions, stockée dans le système de fichiers local avec récupération sémantique
La mémoire à long terme permet à DeerFlow de “se souvenir” de vos précédents résultats de travail, de vos préférences de configuration et du contexte du projet — devenant véritablement plus intelligent à mesure que vous l’utilisez.
2.6 Système de compétences (Skills)
Le système de compétences de DeerFlow est défini via des fichiers Markdown, chaque compétence contenant :
- Conditions de déclenchement (quand utiliser cette compétence)
- Étapes d’exécution (quoi faire spécifiquement)
- Dépendances aux outils (quels outils sont nécessaires)
- Format de sortie (comment les résultats sont présentés)
Les compétences peuvent intégrer des services externes via le protocole MCP (Model Context Protocol) ou être entièrement personnalisées.
3. Guide de déploiement complet
3.1 Exigences environnementales
| Composant | Minimum | Recommandé |
|---|---|---|
| Python | 3.12+ | 3.12 |
| Node.js | 22+ | 22 LTS |
| Docker | 24+ | 24+ (production) |
| RAM | 8GB | 16GB+ |
| Disque | 10GB | 20GB+ |
3.2 Méthode 1 : Déploiement Docker (recommandé)
# 1. Cloner le dépôt
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 2. Configurer les variables d'environnement
cp .env.example .env
# Éditer .env avec votre clé API LLM
# Supporte : OpenAI, Anthropic, Google Gemini, Doubao, DeepSeek, etc.

# 3. Démarrer les services
docker compose up -d

# 4. Accéder
# Frontend : http://localhost:2026
# API : http://localhost:2026/api
3.3 Méthode 2 : Déploiement de développement local
# 1. Cloner le dépôt
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 2. Configuration du backend
cd backend
python -m venv .venv
source .venv/bin/activate
pip install -e ".[dev]"

# Copier et éditer la configuration
cp config.yaml.example config.yaml
# Éditer config.yaml pour configurer les clés API des modèles

# 3. Configuration du frontend
cd ../frontend
npm install

# 4. Démarrer les services
# Terminal 1 : Démarrer le backend
cd backend && python -m app.gateway.app

# Terminal 2 : Démarrer le frontend
cd frontend && npm run dev

# 5. Accéder à http://localhost:3000
3.4 Configuration des modèles
DeerFlow prend en charge plusieurs fournisseurs de LLM. Recommandations officielles :
| Modèle | Cas d’utilisation | Remarques |
|---|---|---|
| Doubao Seed-2.0-Code | Tâches de codage | Propre à ByteDance, profondément intégré avec DeerFlow |
| DeepSeek v3.2 | Tâches générales | Excellent rapport qualité-prix, bonnes capacités en chinois |
| Kimi 2.5 | Traitement de longs textes | Fenêtre de contexte ultra-longue |
| Claude 3.5 Sonnet | Raisonnement complexe | Premier choix pour les scénarios en anglais |
| GPT-4o | Tâches multimodales | Compréhension mixte image-texte |
Configurer dans config.yaml :
models:
  default:
    provider: openai
    model: deepseek-v3.2
    api_key: ${DEEPSEEK_API_KEY}

  reasoning:
    provider: anthropic
    model: claude-3.5-sonnet
    api_key: ${ANTHROPIC_API_KEY}
3.5 Configuration de la sandbox
# config.yaml
sandbox:
  # Utiliser LocalSandbox pour le développement local
  provider: local

  # Utiliser DockerSandbox pour la production
  # provider: docker
  # docker:
  #   image: python:3.12-slim
  #   memory_limit: "2g"
  #   cpu_limit: "2.0"
4. Cas pratique : analyse concurrentielle avec DeerFlow
Passons en revue un cas concret pour ressentir les capacités de DeerFlow 2.0.
4.1 Description de la tâche
“Aidez-moi à analyser les stratégies de tarification, les différences de fonctionnalités principales et les avis des utilisateurs de Notion, Obsidian et Logseq. Générez un rapport de comparaison.”
4.2 Processus d’exécution de DeerFlow
Étape 1 : Décomposition de la tâche
L’agent principal décompose la tâche en 4 sous-tâches :
- Rechercher la tarification, les fonctionnalités et les avis des utilisateurs de Notion
- Rechercher la tarification, les fonctionnalités et les avis des utilisateurs d’Obsidian
- Rechercher la tarification, les fonctionnalités et les avis des utilisateurs de Logseq
- Agréger et générer le rapport
Étape 2 : Exécution parallèle
3 sous-agents démarrent simultanément dans des sandbox, chacun utilisant des outils de navigateur pour visiter les sites officiels des produits cibles, les pages de tarification et les pages d’avis Reddit/G2.
Étape 3 : Agrégation de l’information
Chaque sous-agent organise les données collectées en format structuré et les enregistre dans le système de fichiers de la sandbox.
Étape 4 : Génération du rapport
Le sous-agent d’agrégation appelle des outils d’exécution de code pour rendre les données sous forme de rapport Markdown + tableaux de comparaison, en sortie vers le répertoire des artefacts.
L’ensemble du processus prend environ 3 à 5 minutes — effectuer le même travail manuellement nécessiterait au moins 2 à 3 heures.
5. Comparaison : DeerFlow vs AutoGPT vs CrewAI vs LangGraph
| Dimension | DeerFlow 2.0 | AutoGPT | CrewAI | LangGraph |
|---|---|---|---|---|
| Positionnement | Moteur SuperAgent | Agent IA autonome | Multi-agent jeu de rôles | Framework d’orchestration de graphe d’état |
| Architecture | Chaîne de middleware + sous-agents | Boucle d’agent unique | Collaboration de rôles | Automate d’état de graphe dirigé |
| Sandbox | ✅ Docker/Local | ❌ Aucune sandbox native | ❌ Aucune sandbox native | ❌ Aucune sandbox |
| Mémoire | ✅ Mémoire persistante intersessions | ⚠️ Limitée | ⚠️ Limitée | ✅ Checkpoint |
| Extension des compétences | ✅ Compétences Markdown + MCP | ⚠️ Plugins | ✅ Définitions d’outils | ✅ Nœuds personnalisés |
| Contrôle du navigateur | ✅ Intégré | ✅ Disponible | ❌ Nécessite une intégration | ❌ Nécessite une intégration |
| Interface Web | ✅ Interface Next.js belle | ⚠️ Interface basique | ❌ Aucune | ⚠️ Studio |
| Difficulté de déploiement | Moyenne (Docker en un clic) | Simple | Simple | Moyenne |
| Cas d’utilisation | Tâches complexes de longue durée | Tâches autonomes simples | Division claire des rôles | Contrôle fin du flux nécessaire |
| Étoiles | 83K+ | 170K+ | 30K+ | 15K+ |
| Licence | MIT | MIT | MIT | MIT |
5.1 Guide de sélection
- Choisissez DeerFlow 2.0 : Vous avez besoin de traiter des tâches complexes de longue durée, d’une sandbox d’exécution de code, d’une belle interface Web, et vous privilégiez la confidentialité des données (déploiement local)
- Choisissez AutoGPT : Vous avez seulement besoin de boucles simples de tâches autonomes, de prototypage rapide
- Choisissez CrewAI : Les tâches peuvent être clairement divisées en plusieurs rôles, simulation de collaboration d’équipe
- Choisissez LangGraph : Vous avez besoin d’un contrôle fin sur le flux d’exécution, de création d’applications d’agents personnalisés
6. Points forts et limites de DeerFlow 2.0
✅ Points forts
- Véritable architecture SuperAgent : Pas seulement un chatbot — un moteur qui orchestre plusieurs sous-agents pour accomplir des tâches complexes
- Sandbox sécurité d’abord : Isolement au niveau du conteneur Docker, l’exécution de code n’affecte pas la machine hôte
- Système de compétences flexible : Compétences définies en Markdown, faible barrière à l’entrée, facile à partager
- Support du protocole MCP : Peut se connecter à des outils et services externes, écosystème ouvert
- Déploiement complètement local : Les données ne quittent jamais votre machine, adapté aux besoins de confidentialité de niveau entreprise
- Interface Web magnifique : Construite avec Next.js, expérience d’interaction de première classe
- Soutien de ByteDance : 83K+ étoiles, communauté active, itérations rapides
⚠️ Limites
- Consommation de ressources élevée : Déploiement complet nécessite 16GB+ de RAM, ne fonctionne pas sur des VPS légers
- Dépendance aux modèles : Nécessite votre propre clé API LLM, les coûts d’exploitation ne sont pas négligeables
- Courbe d’apprentissage : Beaucoup d’options de configuration, les débutants ont besoin de temps pour se familiariser
- Documentation chinoise à améliorer : La documentation principale est principalement en anglais
- Incompatibilité 2.0 avec 1.x : La mise à niveau nécessite un redéploiement complet
7. Questions fréquemment posées (FAQ)
Q1 : DeerFlow 2.0 est-il gratuit ?
Oui, DeerFlow 2.0 utilise la licence open-source MIT et est entièrement gratuit à utiliser. Cependant, son exécution nécessite des API LLM (comme DeepSeek, OpenAI, etc.), qui engendrent des coûts d’appel API.
Q2 : DeerFlow peut-il s’exécuter sur une machine sans GPU ?
Oui : DeerFlow lui-même n’appelle pas de modèles locaux — il appelle des LLM cloud via API. Ainsi, une machine CPU suffit, aucun GPU nécessaire.
Q3 : Quelle est la différence entre DeerFlow et ChatGPT ?
ChatGPT est un produit de conversation cloud avec des données stockées sur les serveurs d’OpenAI. DeerFlow est un cadre d’agent déployé localement avec des données entièrement sur votre machine. DeerFlow peut également exécuter du code, manipuler des navigateurs et gérer des fichiers — des choses que ChatGPT ne peut pas faire.
Q4 : Quels modèles linguistiques DeerFlow prend-il en charge ?
Tous les principaux LLM : OpenAI GPT-4o, Anthropic Claude, Google Gemini, DeepSeek, Doubao, Kimi, Qwen, etc. Connectés via des API compatibles OpenAI.
Q5 : DeerFlow convient-il aux développeurs individuels ou aux entreprises ?
Les deux : Les développeurs individuels peuvent utiliser le mode LocalSandbox pour une mise en route rapide ; les entreprises peuvent utiliser le mode DockerSandbox + isolation multi-utilisateurs pour un déploiement en production.
Q6 : Comment passer de DeerFlow 1.x à 2.0 ?
2.0 est une réécriture complète — la mise à niveau directe n’est pas prise en charge. Vous devez redéployer la version 2.0. La version 1.x est toujours maintenue sur la branche main-1.x, mais le développement de nouvelles fonctionnalités se concentre sur 2.0.
8. Conclusion
DeerFlow 2.0 représente une étape importante dans les frameworks d’agents IA open-source. Il ne se contente plus d’être une “IA qui discute” — il s’est transformé en un ouvrier IA qui pense, exécute et se souvient, disponible 24/7.
Pour les développeurs, la valeur de DeerFlow 2.0 réside dans :
- Réduction de la barrière au développement d’applications IA : Pas besoin de construire l’infrastructure d’agent depuis zéro
- Augmentation de l’automatisation des tâches complexes : L’orchestration multi-agents permet à l’IA de réellement “accomplir du travail”
- Garantie de la sécurité des données : Déploiement complètement local, les données ne quittent jamais vos locaux
Si vous recherchez un cadre d’agents IA open-source, puissant et déployable localement, DeerFlow 2.0 mérite une évaluation sérieuse.
Liens de référence :
- Dépôt GitHub de DeerFlow
- Site officiel de DeerFlow
- Documentation d’architecture de DeerFlow
- Plan de coding de ByteDance
J’espère que cette analyse approfondie vous a été utile ! Si vous utilisez déjà DeerFlow 2.0, n’hésitez pas à partager votre expérience dans la section commentaires.