DeerFlow 2.0 実測:ByteDance オープンソース SuperAgent、24時間稼働 AI 従業員の詳細分析
一、DeerFlow 2.0 とは?深層研究からスーパーエージェントへの進化
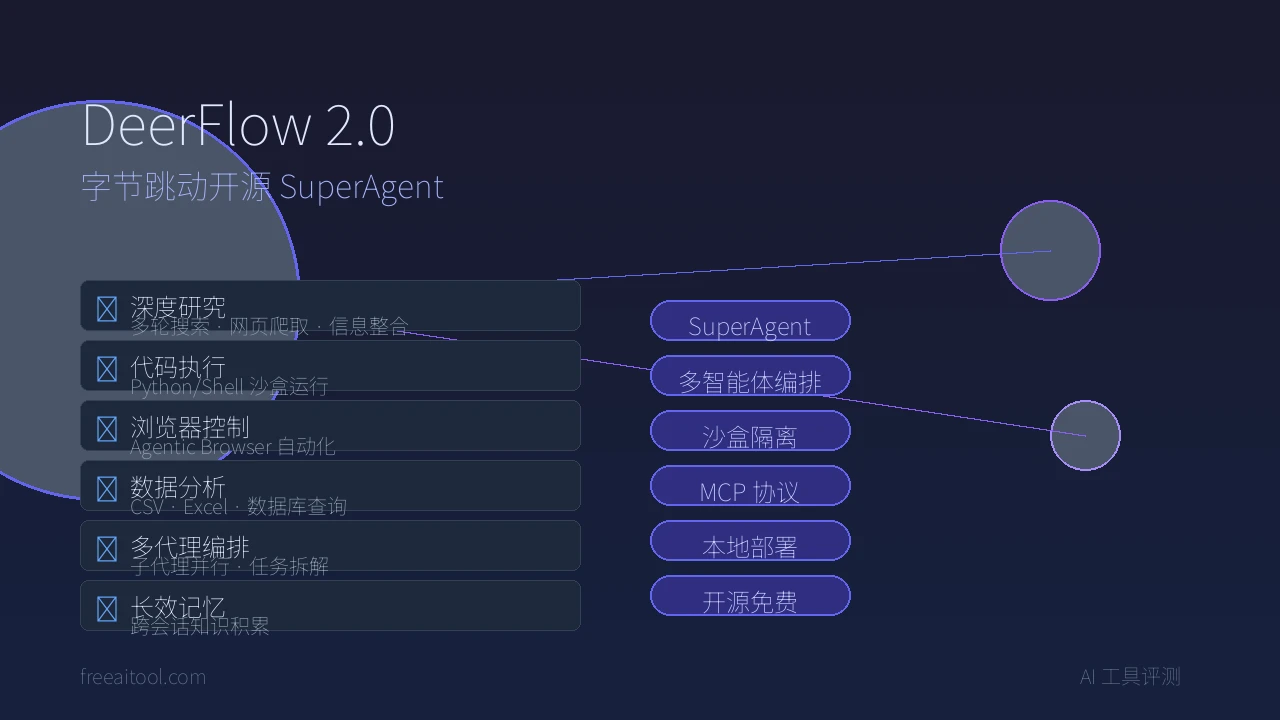
2026 年 2 月、ByteDance は DeerFlow 2.0 を正式にリリースしました。これはゼロからの完全な書き直しであり、1.x バージョンとはコードを一切共有せず、182 の PR を統合して、DeerFlow を「深層研究フレームワーク」から完全にオープンソース SuperAgent エンジンへと進化させました。
DeerFlow の正式名称は Deep Exploration and Efficient Research Flow(深層探索と効率的な研究フロー)です。GitHub で83,000 以上の Star を獲得し、2026 年で最もホットなオープンソース AI プロジェクトの一つとなっています。
1.1 一言での位置づけ
DeerFlow 2.0 はオープンソースのスーパーエージェントオーケストレーションフレームワーク(SuperAgent Harness)であり、サブエージェントの編成、メモリの管理、サンドボックスの分離を行い、拡張可能なスキルシステムを通じてほぼあらゆる複雑なタスクを完了できます。
1.0 バージョンが「深層研究」のみを行っていたのとは異なり、2.0 バージョンの DeerFlow は以下のことができます:
- 🔬 深層研究:多輪検索、Web クローリング、情報統合
- 💻 コード作成:サンドボックスで Python/Shell を実行し、実行可能なプログラムを生成
- 🌐 Web ブラウズ:組み込みの Agentic Browser 制御で、Web ページを自動操作
- 📊 データ分析:CSV、Excel、データベースクエリを処理
- 📝 コンテンツ作成:レポート、PPT、ドキュメントを生成
- 🤖 マルチタスクオーケストレーション:複雑なタスクを複数のサブエージェントに分割して並列実行
1.2 なぜ注目すべきか?
| 特性 | DeerFlow 2.0 | 従来の AI アシスタント |
|---|---|---|
| タスクの複雑さ | 長期的、多段階、クロスドメイン | 単一ターン问答 |
| 実行環境 | 分離されたサンドボックス、コード実行可能 | テキスト生成のみ |
| メモリ機能 | クロスセッション永続メモリ | メモリなしまたは短期コンテキスト |
| ツール拡張 | MCP プロトコル + カスタムスキル | 固定機能セット |
| マルチエージェント | サブエージェント編成、並列処理 | 単一エージェント直列 |
| デプロイ方法 | 完全ローカル、データが外に出ない | クラウド API 依存 |
二、コア技術アーキテクチャ解析
DeerFlow 2.0 のアーキテクチャ設計は、ByteDance の大規模 AI システムにおけるエンジニアリング経験を体現しています。層ごとに分解していきましょう。
2.1 全体アーキテクチャ:3 層分離
┌─────────────────────────────────────────────────────┐
│           クライアント(ブラウザ / TUI ターミナル)      │
└──────────────────────┬──────────────────────────────┘
                       │
                       ▼
┌─────────────────────────────────────────────────────┐
│              Nginx リバースプロキシ(ポート 2026)      │
│    /api/*  → Gateway API (8001)                      │
│    /*      → Frontend (3000)                         │
└──────────────────────┬──────────────────────────────┘
                       │
          ┌────────────┴────────────┐
          ▼                         ▼
┌──────────────────┐      ┌──────────────────┐
│  Gateway API     │      │   Frontend       │
│  (FastAPI:8001)  │      │  (Next.js:3000)  │
│                  │      │                  │
│ • Agent Runtime  │      │ • React UI       │
│ • LangGraph 互換 │      │ • チャット画面    │
│ • SSE ストリーミング│     │ • プロジェクト管理│
│ • MCP/Skills     │      │ • アーティファクト│
└──────────────────┘ └──────────────────┘重要な設計決定:Agent Runtime は FastAPI Gateway に直接組み込まれており、LangGraph Server を個別にデプロイするのではなく、1 つのプロセスで API リクエストと Agent 実行の両方を処理します。これにより運用コストが削減されます。
2.2 ミドルウェアチェーン:8 層の処理パイプライン
各 Agent 実行前に、リクエストは 8 層のミドルウェアを通過します:
- ThreadDataMiddleware — ワークスペース、アップロードディレクトリ、出力ディレクトリを初期化
- UploadsMiddleware — ユーザーがアップロードしたファイル(ドキュメント、画像)を処理
- SandboxMiddleware — サンドボックス実行環境を取得
- SummarizationMiddleware — コンテキスト圧縮(トークンオーバーフローを防止)
- TitleMiddleware — 会話タイトルを自動生成
- TodoListMiddleware — タスク追跡(計画モード)
- ViewImageMiddleware — ビジョンモデルサポート(画像理解)
- ClarificationMiddleware — 明確化リクエストを処理
このミドルウェアパターンは Web フレームワークの設計哲学を取り入れており、各層は単一の責任を持ち、プラグイン可能です。
2.3 サンドボックスシステム:安全なコード実行
DeerFlow のサンドボックスは、通常のチャットボットと異なる核心機能です。2 つのモードを提供します:
| モード | 適用シナリオ | 分離レベル |
|---|---|---|
| LocalSandbox | ローカル開発、個人使用 | プロセスレベル分離 |
| DockerSandbox | 本番デプロイ、マルチユーザー | コンテナレベル分離 |
サンドボックスは完全なファイルシステム操作をサポートします:コマンド実行、ファイルの読み書き、ディレクトリ一覧表示。すべての操作は仮想パスマッピングを通じて実装され、Agent はホストマシンの実際のファイルシステムにアクセスできません。
2.4 サブエージェントオーケストレーション:タスク分解と並列処理
DeerFlow 2.0 の核心イノベーションはサブエージェントオーケストレーションシステムです。複雑なタスクに直面したとき、メインエージェント(Lead Agent)は以下の処理を行います:
- タスク分析:タスクの目標と制約を理解
- サブタスク分解:大きなタスクを独立して実行可能なサブタスクに分割
- サブエージェント割り当て:各サブタスク用に特化したサブエージェントを作成
- 並列実行:複数のサブエージェントがそれぞれのサンドボックスで同時に作業
- 結果統合:すべてのサブエージェントの出力を収集し、最終結果として統合
# サブエージェントオーケストレーションの擬似コード
lead_agent.receive("10 社の競合の価格戦略を分析してレポートを作成")
  → sub_agent_1: 競合 A、B、C の価格を研究
  → sub_agent_2: 競合 D、E、F の価格を研究
  → sub_agent_3: 競合 G、H、I、J の価格を研究
  → sub_agent_4: データを集約し、比較レポートを生成
2.5 永続メモリシステム(DeerMem)
DeerFlow のメモリシステムは 2 層で構成されています:
- セッションメモリ:現在の会話のコンテキスト。LangGraph の Checkpoint メカニズムを通じて永続化
- 長期メモリ:クロスセッションの知識蓄積。ローカルファイルシステムに保存され、セマンティック検索をサポート
長期メモリにより、DeerFlow はあなたの以前の作業成果、設定、プロジェクト背景を「記憶」し、「使えば使うほどあなたを理解する」ようになります。
2.6 スキルシステム(Skills)
DeerFlow のスキルシステムは Markdown ファイルに基づいて定義され、各スキルは以下を含みます:
- トリガー条件(いつこのスキルを使用するか)
- 実行ステップ(具体的に何をするか)
- ツール依存関係(どのツールが必要か)
- 出力形式(結果をどのように表示するか)
スキルは MCP(Model Context Protocol)プロトコルを通じて外部サービスと統合することも、完全にカスタマイズすることもできます。
三、完全デプロイチュートリアル
3.1 環境要件
| コンポーネント | 最低バージョン | 推奨バージョン |
|---|---|---|
| Python | 3.12+ | 3.12 |
| Node.js | 22+ | 22 LTS |
| Docker | 24+ | 24+(本番デプロイ) |
| メモリ | 8GB | 16GB+ |
| ディスク | 10GB | 20GB+ |
3.2 方法 1:Docker デプロイ(推奨)
# 1. リポジトリをクローン
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 2. 環境変数を設定
cp .env.example .env
# .env を編集して LLM API キーを入力
# サポート:OpenAI、Anthropic、Google Gemini、豆包、DeepSeek など

# 3. サービスを起動
docker compose up -d

# 4. アクセス
# フロントエンド:http://localhost:2026
# API インターフェース:http://localhost:2026/api
3.3 方法 2:ローカル開発デプロイ
# 1. リポジトリをクローン
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow

# 2. バックエンド設定
cd backend
python -m venv .venv
source .venv/bin/activate
pip install -e ".[dev]"

# 設定をコピーして編集
cp config.yaml.example config.yaml
# config.yaml を編集してモデル API キーを設定

# 3. フロントエンド設定
cd ../frontend
npm install

# 4. サービスを起動
# ターミナル 1:バックエンドを起動
cd backend && python -m app.gateway.app

# ターミナル 2:フロントエンドを起動
cd frontend && npm run dev

# 5. http://localhost:3000 にアクセス
3.4 モデル設定
DeerFlow は複数の LLM プロバイダーをサポートし、公式推奨は以下の通りです:
| モデル | 適用シナリオ | 備考 |
|---|---|---|
| 豆包 Seed-2.0-Code | コーディングタスク | ByteDance 自社開発、DeerFlow と深く統合 |
| DeepSeek v3.2 | 汎用タスク | コストパフォーマンスが高く、中国語能力が強い |
| Kimi 2.5 | 長文処理 | 超長コンテキストウィンドウ |
| Claude 3.5 Sonnet | 複雑な推論 | 英語シナリオの第一選択 |
| GPT-4o | マルチモーダルタスク | 画像とテキストの混合理解 |
config.yaml で設定します:
models:
  default:
    provider: openai
    model: deepseek-v3.2
    api_key: ${DEEPSEEK_API_KEY}

  reasoning:
    provider: anthropic
    model: claude-3.5-sonnet
    api_key: ${ANTHROPIC_API_KEY}
3.5 サンドボックス設定
# config.yaml
sandbox:
  # ローカル開発用 LocalSandbox
  provider: local

  # 本番デプロイ用 DockerSandbox
  # provider: docker
  # docker:
  #   image: python:3.12-slim
  #   memory_limit: "2g"
  #   cpu_limit: "2.0"
四、実践ケース:DeerFlow で競合分析を実行
実際のケースを通じて、DeerFlow 2.0 の能力を体験しましょう。
4.1 タスク説明
“Notion、Obsidian、Logseq の 3 つのノートツールの価格戦略、核心機能の違い、ユーザーの評判を分析し、比較レポートを作成してください。“
4.2 DeerFlow の実行プロセス
ステップ 1:タスク分解
Lead Agent はタスクを 4 つのサブタスクに分解します:
- Notion の価格、機能、ユーザー評価を研究
- Obsidian の価格、機能、ユーザー評価を研究
- Logseq の価格、機能、ユーザー評価を研究
- 比較してレポートを生成
ステップ 2:並列実行
3 つのサブエージェントがサンドボックスで同時に起動し、それぞれブラウザツールを使用してターゲット製品の公式ウェブサイト、価格ページ、Reddit/G2 評価ページにアクセスします。
ステップ 3:情報統合
各サブエージェントは収集したデータを構造化形式で整理し、サンドボックスファイルシステムに保存します。
ステップ 4:レポート生成
集約サブエージェントはコード実行ツールを呼び出し、データを Markdown レポート + 比較テーブルとしてレンダリングし、アーティファクトディレクトリに出力します。
全体プロセスは約 3-5 分で完了します。同じ作業を手動で行う場合、少なくとも 2-3 時間かかります。
五、横断比較:DeerFlow vs AutoGPT vs CrewAI vs LangGraph
| 次元 | DeerFlow 2.0 | AutoGPT | CrewAI | LangGraph |
|---|---|---|---|---|
| 位置づけ | SuperAgent エンジン | 自律 AI エージェント | ロールプレイマルチエージェント | ステートグラフオーケストレーションフレームワーク |
| アーキテクチャ | ミドルウェアチェーン + サブエージェント | 単一エージェントループ | ロール協調 | 有向グラフステートマシン |
| サンドボックス | ✅ Docker/ローカル | ❌ ネイティブサンドボックスなし | ❌ ネイティブサンドボックスなし | ❌ サンドボックスなし |
| メモリ | ✅ クロスセッション永続メモリ | ⚠️ 制限あり | ⚠️ 制限あり | ✅ Checkpoint |
| スキル拡張 | ✅ Markdown スキル + MCP | ⚠️ プラグイン | ✅ ツール定義 | ✅ カスタムノード |
| ブラウザ制御 | ✅ 組み込み | ✅ あり | ❌ 統合必要 | ❌ 統合必要 |
| Web UI | ✅ Next.js 精美インターフェース | ⚠️ 基本インターフェース | ❌ なし | ⚠️ Studio |
| デプロイ難易度 | 中程度(Docker ワンクリック) | 簡単 | 簡単 | 中程度 |
| 適用シナリオ | 長期的複雑タスク | 単純自律タスク | 明確な役割分担 | 細かい制御フロー必要 |
| Star 数 | 83K+ | 170K+ | 30K+ | 15K+ |
| ライセンス | MIT | MIT | MIT | MIT |
5.1 選択アドバイス
- DeerFlow 2.0 を選択:長期的複雑タスクの処理、コード実行サンドボックスの必要性、精美な Web UI、データプライバシー重視(ローカルデプロイ)
- AutoGPT を選択:単純な自律タスクループのみ、迅速なプロトタイプ検証
- CrewAI を選択:タスクを複数の役割に明確に分割可能、チーム協調シミュレーション
- LangGraph を選択:実行フローの細かい制御が必要、カスタム Agent アプリケーションの構築
六、DeerFlow 2.0 のハイライトと不足
✅ ハイライト
- 真の SuperAgent アーキテクチャ:単純なチャットボットではなく、複数のサブエージェントを編成して複雑なタスクを完了できるエンジン
- 安全第一のサンドボックス:Docker レベルの分離、コード実行がホストマシンに影響しない
- 柔軟なスキルシステム:Markdown でスキルを定義、間口が低く共有しやすい
- MCP プロトコルサポート:外部ツールやサービスに接続可能、オープンなエコシステム
- 完全ローカルデプロイ:データがマシンから出ず、企業レベルのプライバシーニーズに適している
- 精美な Web UI:Next.js で構築、一流のインタラクション体験
- ByteDance のバックアップ:83K+ Star、コミュニティが活発、迭代が速い
⚠️ 不足
- リソース消費が高い:完全デプロイには 16GB+ メモリが必要、軽量 VPS では動作しない
- モデル依存:LLM API キーを自分で用意する必要があり、運用コストは低くない
- 学習曲線:設定項目が多く、初心者が始めるには時間が必要
- 中国語ドキュメントの整備が必要:核心ドキュメントは主に英語
- 2.0 は 1.x と互換性なし:アップグレードには完全な再デプロイが必要
七、よくある質問 FAQ
Q1:DeerFlow 2.0 は無料ですか?
はい、DeerFlow 2.0 は MIT オープンソースライセンスを採用しており、完全に無料で使用できます。ただし、実行時には LLM API(DeepSeek、OpenAI など)が必要で、これらの API 呼び出しには費用が発生します。
Q2:DeerFlow は GPU なしのマシンで実行できますか?
できます。DeerFlow 自体はローカルモデルを呼び出さず、API を通じてクラウド LLM を呼び出します。したがって CPU マシンで実行可能で、GPU は必要ありません。
Q3:DeerFlow と ChatGPT の違いは何ですか?
ChatGPT はクラウドベースの会話製品で、データは OpenAI のサーバーに保存されます。DeerFlow はローカルにデプロイされた Agent フレームワークで、データは完全にあなたのマシンにあります。DeerFlow はコードの実行、ブラウザの操作、ファイルの管理もできます——これらは ChatGPT ではできないことです。
Q4:DeerFlow はどの言語モデルをサポートしていますか?
すべての主要 LLM をサポート:OpenAI GPT-4o、Anthropic Claude、Google Gemini、DeepSeek、豆包(Doubao)、Kimi、通義千問など。OpenAI 互換 API 経由で接続します。
Q5:DeerFlow は個人開発者向けですか、それとも企業向けですか?
両方とも適しています。個人開発者は LocalSandbox モードで迅速に始めることができます。企業は DockerSandbox + マルチユーザー分離モードを使用して本番デプロイを行うことができます。
Q6:DeerFlow 1.x から 2.0 へのアップグレード方法は?
2.0 は完全な書き直しであり、直接アップグレードはサポートされていません。2.0 バージョンを再デプロイする必要があります。1.x バージョンは main-1.x ブランチで引き続きメンテナンスされていますが、新機能開発は 2.0 に集中しています。
八、まとめ
DeerFlow 2.0 は、オープンソース AI Agent フレームワークの重要なマイルストーンを表しています。もはや「チャットする AI」满足于することなく、考え、実行し、記憶する 24 時間稼働の AI 従業員へと進化しました。
開発者にとって、DeerFlow 2.0 の価値は以下の通りです:
- AI アプリケーション開発のハードルを下げる:ゼロから Agent インフラを構築する必要がない
- 複雑なタスクの自動化レベルを向上させる:マルチエージェントオーケストレーションにより、AI が実際に「作業を行う」
- データセキュリティを保障する:完全ローカルデプロイ、データが外部に出ない
オープンソースで強力で、ローカルデプロイ可能な AI Agent フレームワークを探している場合、DeerFlow 2.0 は真剣に評価する価値があります。
参考リンク:
この詳細分析があなたの役に立てば幸いです!すでに DeerFlow 2.0 を使用している場合は、コメント欄であなたの使用体験を共有してください。