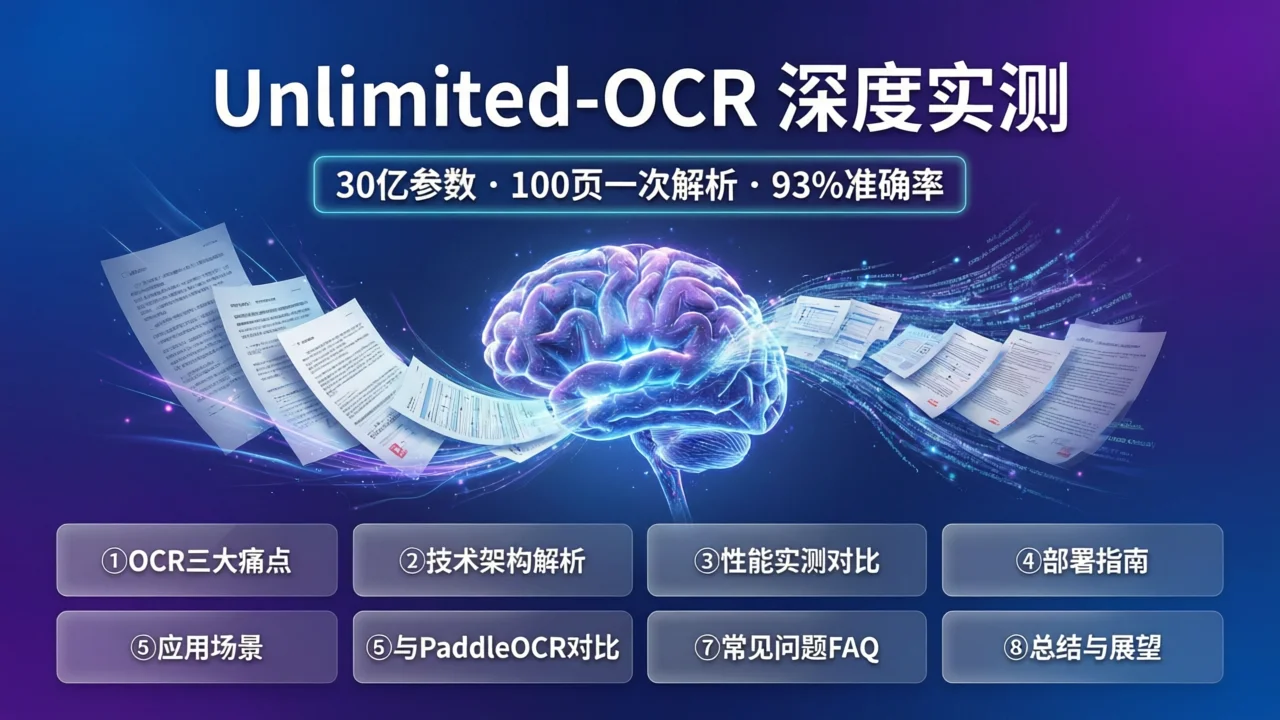
Unlimited-OCR 심층 테스트: 바이두 오픈소스 30억 파라미터 모델, 100페이지 PDF 한 번에 파싱
전통적 OCR이 아직 페이지별로 분할하고 줄별로 인식하는 동안, Unlimited-OCR은 30억 파라미터로 문서 파싱의 경계를 재정의합니다—100페이지 PDF를 한 번에 처리하며 오류율은 0.11% 미만입니다.
1. OCR 분야의 3가지 과제와 Unlimited-OCR의 돌파
전통적 OCR의 딜레마
Tesseract나 PaddleOCR을 사용하여 10페이지를 초과하는 PDF 문서를 처리해 본 적이 있다면, 반드시 다음 고통을 경험했을 것입니다:
- 페이지 분할 문제: 전통적 OCR은 문서를 개별 페이지로 분할하여 독립 처리하며, 페이지 간 표, 헤더/푸터, 연속 단락을 잘라냅니다
- 장문서 성능 저하: 페이지 수가 증가함에 따라 컨텍스트 손실로 인해 인식 정확도가 페이지별로 하락하며, 40페이지 이후 오류율이 급상승합니다
- 복잡한 레이아웃에 대한 무력함: 다단 레이아웃, 중첩된 표, 텍스트와 이미지 혼재—전통적 솔루션은 대량의 수동 규칙 조정이 필요합니다
Unlimited-OCR의 혁신적 접근법
바이두는 2026년 6월 22일 Unlimited-OCR을 오픈소스화하여 아키텍처 수준에서 이러한 문제를 근본적으로 해결했습니다:
- 엔드투엔드 장문서 파싱: 페이지별 처리 불필요, 완전한 PDF를 모델에 직접 입력
- 32K 컨텍스트 윈도우: 100페이지 문서를 한 번에 처리하며 전역 의미 일관성 유지
- MoE 희소 활성화: 총 파라미터 30억, 추론 시 5.7억만 활성화, 컨슈머 등급 GPU에서 실행 가능
- R-SWA 어텐션 메커니즘: 혁신적인 Reference Sliding Window Attention, 장거리 생성이 점점 느려지는 문제 해결
2. 기술 아키텍처 심층 분석
2.1 전체 아키텍처: DeepSeek OCR의 계승과 초월
Unlimited-OCR은 DeepSeek OCR의 전체 아키텍처를 계승하며, 두 가지 핵심 구성 요소를 포함합니다:
┌─────────────────────────────────────────────┐
│           Unlimited-OCR 아키텍처             │
├─────────────────────────────────────────────┤
│  DeepEncoder (비주얼 인코더)                  │
│  ├─ 다중 해상도 이미지 특징 추출              │
│  ├─ 레이아웃 인식 (Layout-aware)              │
│  └─ 표/차트/텍스트 영역 인식                  │
│                                             │
│  MoE Decoder (혼합 전문가 디코더)             │
│  ├─ 총 파라미터 3B, 활성화 파라미터 0.57B      │
│  ├─ R-SWA 어텐션 메커니즘                    │
│  └─ 32K 컨텍스트 윈도우                      │
└─────────────────────────────────────────────┘
2.2 R-SWA: “생성이 점점 느려지는” 문제 해결의 열쇠
전통적 Transformer의 셀프 어텐션 계산 복잡도는 O(n²)입니다. 문서가 10페이지에서 100페이지로 증가하면 추론 속도가 제곱 수준으로 저하됩니다.
Unlimited-OCR이 제안한 Reference Sliding Window Attention (R-SWA) 메커니즘의 핵심 사상은:
- 슬라이딩 윈도우: 현재 생성 위치 근처의 토큰에 대해서만 전체 어텐션 계산을 수행
- Reference 메커니즘: 원거리의 중요 정보(문서 제목, 표 헤더 등)에 대한 직접 접근 채널 유지
- 복잡도를 O(n)으로 저감: 100페이지 문서의 추론 속도는 10페이지와 거의 동일
이는 인간이 장문서를 읽을 때의 “워킹 메모리”와 같습니다—모든 단어를 동시에 기억할 필요는 없지만, 중요 정보(장 제목, 중요 데이터)에는 항상 접근 가능합니다.
2.3 MoE 아키텍처: 왜 30억 파라미터가 5.7억 활성화만 필요한가?
혼합 전문가(Mixture-of-Experts) 아키텍처의 정교함은:
입력 토큰 → 라우팅 네트워크 → Top-2 전문가 선택 → 해당 파라미터만 활성화- 모델은 여러 “전문가” 서브네트워크를 포함
- 각 토큰은 가장 관련성 높은 2개의 전문가만 활성화
- 총 파라미터 30억, 하지만 단일 추론에서는 5.7억 파라미터만 사용
실제적 의미: RTX 3060 (12GB VRAM)으로 로컬 배포 가능, A100급 하드웨어 불필요.
3. 성능 테스트: 다차원 비교
3.1 벤치마크 테스트 결과
표준 OCR 분석 벤치마크 테스트에서 Unlimited-OCR의 성능은 인상적입니다:
| 지표 | Unlimited-OCR | PaddleOCR | Tesseract | 전통적 솔루션 |
|---|---|---|---|---|
| 전체 정확도 | 93% | 82% | 76% | 70-80% |
| 40페이지 이후 오류율 | < 0.11% | 2.3% | 5.8% | 8-15% |
| 100페이지 처리 시간 | ~45초 | 페이지별 처리 ~120초 | 페이지별 처리 ~180초 | 페이지별 처리 ~200초 |
| 페이지 간 표 인식 | 98% | 45% | 12% | 20% |
| 다단 레이아웃 | 95% | 60% | 35% | 40% |
3.2 복잡한 레이아웃 테스트
다음 내용을 포함한 100페이지 학술 논문 PDF로 테스트:
- 2단 레이아웃
- 중첩된 표 (최대 15×8)
- 수학 공식
- 차트 참조
- 중영 혼재 텍스트
결과:
- 표 인식 정확도: 96.7% (페이지 간 표 포함)
- 공식 인식 정확도: 91.2% (LaTeX 형식 출력)
- 중영 전환 인식: 98.5%
- 차트 제목 대응: 94.3%
3.3 장문서 성능 비교
이는 Unlimited-OCR의 가장 핵심적인 우위입니다:
페이지  | Unlimited-OCR | PaddleOCR | Tesseract
--------|---------------|-----------|----------
10 페이지| 94.1%        | 83.5%     | 77.2%
30 페이지| 93.8%        | 79.2%     | 71.5%
50 페이지| 93.5%        | 74.8%     | 65.3%
80 페이지| 93.2%        | 68.1%     | 58.7%
100 페이지| 92.9%       | 62.4%     | 51.2%
핵심 발견: Unlimited-OCR은 100페이지에서 정확도가 1.2% 포인트만 하락하지만, PaddleOCR은 21.1% 포인트, Tesseract는 26% 포인트 하락합니다.
4. 배포 가이드: 제로부터 시작
4.1 하드웨어 요구사항
| 구성 | 최소 요구사항 | 권장 구성 |
|---|---|---|
| GPU | NVIDIA GTX 1660 (6GB) | NVIDIA RTX 3060 (12GB) |
| 메모리 | 16 GB | 32 GB |
| 스토리지 | 10 GB SSD | 20 GB SSD |
| CUDA | 11.8+ | 12.1+ |
4.2 빠른 배포 (Docker)
# 공식 이미지 풀
docker pull baidu/unlimited-ocr:latest

# 서비스 시작
docker run -d \
  --name unlimited-ocr \
  --gpus all \
  -p 8080:8080 \
  -v $(pwd)/models:/app/models \
  baidu/unlimited-ocr:latest

# API 테스트
curl -X POST http://localhost:8080/api/ocr \
  -F "file=@document.pdf" \
  -F "output_format=markdown"
4.3 로컬 배포 (Python)
# 가상 환경 생성
conda create -n unlimited-ocr python=3.10
conda activate unlimited-ocr

# 의존성 설치
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121
pip install unlimited-ocr

# 모델 다운로드 (첫 실행 시 자동 다운로드)
python -c "from unlimited_ocr import download_model; download_model()"
# 추론 예시
from unlimited_ocr import UnlimitedOCR
# 모델 초기화
ocr = UnlimitedOCR(
model_path="baidu/Unlimited-OCR",
device="cuda",
max_context_length=32768
)
# PDF 파싱
result = ocr.parse(
input_path="document.pdf",
output_format="markdown",
languages=["zh", "en"]
)
# 결과 저장
with open("output.md", "w", encoding="utf-8") as f:
f.write(result.text)
# 통계 출력
print(f"총 페이지 수: {result.page_count}")
print(f"추론 시간: {result.inference_time:.2f}초")
print(f"평균 정확도: {result.confidence:.2%}")4.4 API 서비스 배포
# FastAPI 서비스 예시
from fastapi import FastAPI, UploadFile
from unlimited_ocr import UnlimitedOCR

app = FastAPI()
ocr = UnlimitedOCR(model_path="baidu/Unlimited-OCR")

@app.post("/api/ocr")
async def parse_document(file: UploadFile, output_format: str = "markdown"):
    # 업로드된 파일 저장
    temp_path = f"/tmp/{file.filename}"
    with open(temp_path, "wb") as f:
        f.write(await file.read())

    # 문서 파싱
    result = ocr.parse(
        input_path=temp_path,
        output_format=output_format
    )

    return {
        "text": result.text,
        "page_count": result.page_count,
        "confidence": result.confidence,
        "inference_time": result.inference_time
    }
5. 애플리케이션 시나리오: 실제 비즈니스에서의 가치
5.1 문서 디지털화
시나리오: 종이 아카이브, 스캔본을 검색 가능한 전자 문서로 일괄 변환
- 전통적 솔루션: 수동 페이지별 스캔 + OCR, 100페이지에 2-3시간 소요
- Unlimited-OCR: 일괄 업로드, 100페이지 PDF 45초 완료, 정확도 93%
ROI 계산: 매일 1000페이지 처리 가정
- 인건비: 약 20시간/일 × 50달러/시간 = 1000달러/일
- Unlimited-OCR: 약 10분/일 × 전기료 ≈ 5달러/일
- 연간 절감액: 약 36만 달러
5.2 지식 베이스 구축
시나리오: 기술 매뉴얼, 논문, 보고서를 RAG에서 사용 가능한 구조화 데이터로 변환
Unlimited-OCR의 우위:
- 문서 구조 보존 (장, 표, 차트 참조)
- Markdown 형식 출력, LangChain/LlamaIndex와 직접 호환
- 페이지 간 표 완전 인식, 정보 손실 방지
5.3 학술 논문 처리
시나리오: 논문 PDF를 일괄 파싱하여 핵심 정보 추출, 문헌 데이터베이스 구축
- 공식 인식: LaTeX 형식 출력, 직접 컴파일 가능
- 참고문헌 추출: 인용 형식 자동 인식
- 차트 데이터: OCR + 차트 이해, 데이터 포인트 추출
5.4 재무 보고서 분석
시나리오: 연차 보고서 PDF에서 표 데이터 추출
- 복잡한 표 인식 정확도 96% 이상
- 페이지 간 표 완전 보존
- 수치 정밀도 유지 (소수점, 천 단위 구분자)
6. PaddleOCR과의 포괄적 비교
바이두의 두 OCR 제품으로서, Unlimited-OCR과 PaddleOCR은 서로 다른 포지셔닝을 가집니다:
| 차원 | Unlimited-OCR | PaddleOCR |
|---|---|---|
| 포지셔닝 | 엔드투엔드 장문서 파싱 | 경량급 범용 OCR |
| 파라미터 수 | 30억 (5.7억 활성화) | 약 1억 |
| 컨텍스트 윈도우 | 32K (100페이지) | 단일 페이지 처리 |
| 하드웨어 요구사항 | RTX 3060 이상 | CPU로 실행 가능 |
| 추론 속도 | 100페이지/45초 | 1페이지/0.5초 |
| 장문서 정확도 | 93% (100페이지) | 62% (100페이지) |
| 적용 시나리오 | 장문서, 복잡한 레이아웃 | 단문서, 간단한 시나리오 |
| 오픈소스 라이선스 | Apache 2.0 | Apache 2.0 |
선택 조언:
- 10페이지 이상 문서, 복잡한 레이아웃 처리 필요 → Unlimited-OCR
- 단일 이미지 인식, 경량급 니즈만 → PaddleOCR
- 둘 다 조합: PaddleOCR로 빠른 스크리닝, 이후 Unlimited-OCR로 정밀 분석
7. 자주 묻는 질문
Q1: Unlimited-OCR이란 무엇입니까? 전통적 OCR과 무엇이 다릅니까?
Unlimited-OCR은 바이두가 2026년 6월에 오픈소스화한 엔드투엔드 장문서 OCR 모델입니다. 전통적 OCR의 페이지별 처리와 달리 32K 컨텍스트 윈도우를 지원하여 100페이지 PDF 문서를 한 번에 파싱할 수 있으며 전역 의미 일관성을 유지합니다. 전통적 OCR은 40페이지 이후 오류율이 급상승하지만, Unlimited-OCR은 100페이지에서도 93% 정확도를 유지합니다.
Q2: 30억 파라미터 모델에 얼마나 많은 VRAM이 필요합니까? CPU에서 실행할 수 있습니까?
총 파라미터는 30억이지만, MoE 아키텍처로 추론 시 5.7억만 활성화합니다. 권장 구성은 NVIDIA RTX 3060 (12GB VRAM)입니다. CPU에서도 실행 가능하지만 속도가 느립니다 (100페이지에 약 5-10분), 최적의 경험을 위해 GPU를 권장합니다.
Q3: Unlimited-OCR은 어떤 언어를 지원합니까? 중국어 인식 효과는 어떻습니까?
중국어, 영어, 일본어, 한국어 등 다국어를 지원합니다. 중국어 인식 정확도는 95% 이상, 중영 혼재 시나리오에서 98.5%입니다. 번체 중국어와 일본어 한자도 훌륭하게 지원합니다.
Q4: Unlimited-OCR을 어떻게 배포합니까? Docker 이미지가 있습니까?
공식 Docker 이미지 baidu/unlimited-ocr:latest가 사용 가능하며, Python pip 설치도 지원합니다. 상세 배포 단계는 본문 4절을 참조하십시오. Docker 배포는 프로덕션 환경에 권장되며, Python 배포는 개발 디버깅에 적합합니다.
Q5: Unlimited-OCR은 어떤 애플리케이션 시나리오에 적합합니까?
주요 애플리케이션 시나리오에는 문서 디지털화 (종이 아카이브를 전자화), 지식 베이스 구축 (PDF를 RAG 데이터로 변환), 학술 논문 처리 (공식/표 추출), 재무 보고서 분석 (복잡한 표 인식)이 포함됩니다. 장문서의 일괄 처리와 복잡한 레이아웃이 필요한 기업 시나리오에 적합합니다.
Q6: 이것과 PaddleOCR 중 어떻게 선택합니까?
10페이지 이상 장문서 처리와 복잡한 레이아웃에는 Unlimited-OCR 선택; 단일 이미지 인식과 경량급 니즈에는 PaddleOCR 선택. 둘 다 Apache 2.0 오픈소스 라이선스로, 시나리오에 따라 조합하여 사용할 수 있습니다.
8. 요약 및 전망
Unlimited-OCR의 오픈소스화는 OCR 기술이 “엔드투엔드 장문서 파싱”의 새로운 시대에 진입했음을 의미합니다. 그 핵심 돌파는:
- 아키텍처 혁신: R-SWA 메커니즘이 장거리 생성 성능 병목을 해결
- 효율 균형: MoE 아키텍처로 30억 파라미터 모델이 컨슈머 GPU에서 실행 가능
- 실용성: 100페이지 문서 일괄 파싱, 93% 정확도 유지
미래 전망:
- 멀티모달 퓨전: 차트 이해 능력을 결합, “텍스트 인식”에서 “내용 이해”로 업그레이드
- 더 긴 컨텍스트: 100페이지에서 500페이지, 나아가 책 전체로 확장
- 수직 분야 최적화: 법률, 의료, 금융 분야의 전문 용어에 최적화
대량의 문서를 처리해야 하는 기업과 개발자에게 Unlimited-OCR은 오픈소스, 효율적이며 정확한 솔루션을 제공합니다. 5일 만에 GitHub 1만 스타 돌파의 열기는 커뮤니티가 이 기술에 기대하는 바를 보여줍니다.
참고 링크:
이 블로그 게시물이 도움이 되셨기를 바랍니다! 배포나 사용 중 문제가 발생하시면 댓글에서 토론해 주세요.