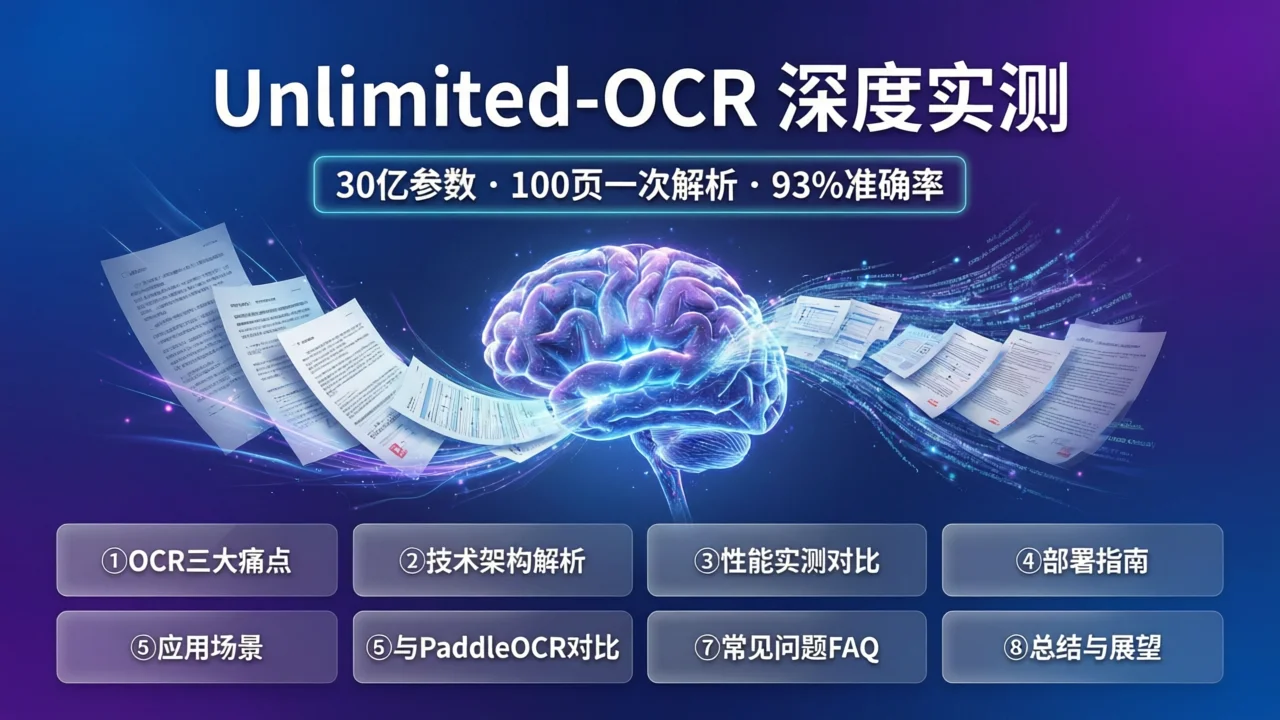
Unlimited-OCR im Tiefentest: Baidus Open-Source-3B-Parameter-Modell parst 100-seitige PDFs in einem Durchgang
Während traditionelle OCR immer noch Seiten schneidet und Zeile für Zeile erkennt, definiert Unlimited-OCR mit 3 Milliarden Parametern die Grenzen der Dokumentanalyse neu—verarbeitet 100-seitige PDFs auf einmal mit Fehlerraten unter 0,11%.
I. Drei Schmerzpunkte bei OCR und Unlimited-OCRs Durchbruch
Das Dilemma traditioneller OCR
Wenn Sie jemals Tesseract oder PaddleOCR verwendet haben, um PDF-Dokumente mit mehr als 10 Seiten zu verarbeiten, haben Sie sicherlich folgende Schmerzen erlebt:
- Seitensegmentierungsproblem: Traditionelle OCR teilt Dokumente in einzelne Seiten zur unabhängigen Verarbeitung, schneidet seitenübergreifende Tabellen, Kopf-/Fußzeilen und fortlaufende Absätze ab
- Leistungsabfall bei langen Dokumenten: Mit steigender Seitenzahl verursacht Kontextverlust, dass die Erkennungsgenauigkeit Seite für Seite sinkt, mit stark steigenden Fehlerraten nach 40 Seiten
- Hilflosigkeit bei komplexen Layouts: Mehrspaltige Layouts, verschachtelte Tabellen, gemischter Text und Bilder—traditionelle Lösungen erfordern umfangreiche manuelle Regelanpassung
Unlimited-OCRs bahnbrechender Ansatz
Baidu open-sourcte Unlimited-OCR am 22. Juni 2026 und löst diese Probleme grundlegend auf Architekturebene:
- End-to-End-Langdokumentanalyse: Keine seitenweise Verarbeitung mehr; direkte Eingabe vollständiger PDFs in das Modell
- 32K-Kontextfenster: Verarbeitet 100-seitige Dokumente auf einmal und bewahrt globale semantische Kohärenz
- MoE-Sparse-Aktivierung: 3 Milliarden Gesamtparameter, aber nur 570 Millionen während der Inferenz aktiviert, lauffähig auf Consumer-GPUs
- R-SWA-Aufmerksamkeitsmechanismus: Innovativer Reference Sliding Window Attention, löst das Problem zunehmend langsamer Langsequenzgenerierung
II. Technische Architektur im Tiefgang
2.1 Gesamtarchitektur: Erbe von und Übertragung von DeepSeek OCR
Unlimited-OCR setzt DeepSeek OCRs Gesamtarchitektur fort und umfasst zwei Kernkomponenten:
┌─────────────────────────────────────────────┐
│           Unlimited-OCR-Architektur         │
├─────────────────────────────────────────────┤
│  DeepEncoder (Visueller Encoder)             │
│  ├─ Multiskalige Bildmerkmalsextraktion      │
│  ├─ Layout-bewusstes Seitenverständnis       │
│  └─ Tabellen/Diagramm/Textbereichserkennung  │
│                                             │
│  MoE-Decoder (Mixture-of-Experts-Decoder)    │
│  ├─ 3B Gesamtparameter, 0,57B aktiviert      │
│  ├─ R-SWA-Aufmerksamkeitsmechanismus         │
│  └─ 32K-Kontextfenster                       │
└─────────────────────────────────────────────┘
2.2 R-SWA: Der Schlüssel zur Lösung “zunehmend langsamer Generierung”
Traditionelle Transformer-Selbstaufmerksamkeit hat O(n²) Berechnungskomplexität. Wenn Dokumente von 10 auf 100 Seiten zunehmen, sinkt die Inferenzgeschwindigkeit quadratisch.
Unlimited-OCRs vorgeschlagener Reference Sliding Window Attention (R-SWA)-Mechanismus basiert auf:
- Gleitendes Fenster: Führt nur vollständige Aufmerksamkeitsberechnung für Tokens nahe der aktuellen Generierungsposition durch
- Referenzmechanismus: Behält direkte Zugriffskanäle zu entfernten Schlüsselinformationen (wie Dokumenttitel, Tabellenüberschriften)
- Komplexität auf O(n) reduziert: Inferenzgeschwindigkeit für 100-seitige Dokumente ist nahezu identisch mit 10-seitigen Dokumenten
Dies ist wie das “Arbeitsgedächtnis” von Menschen beim Lesen langer Dokumente—Sie müssen nicht jedes Wort gleichzeitig erinnern, aber Sie behalten immer Zugriff auf Schlüsselinformationen (Kapiteltitel, wichtige Daten).
2.3 MoE-Architektur: Warum 3B Parameter nur 570M aktivierte benötigen?
Die Eleganz der Mixture-of-Experts-Architektur liegt in:
Eingabe-Token → Routing-Netzwerk → Top-2-Experten auswählen → Nur entsprechende Parameter aktivieren- Das Modell enthält mehrere “Experten”-Subnetzwerke
- Jedes Token aktiviert nur die 2 relevantesten Experten
- Gesamtparameter 3 Milliarden, aber einzelne Inferenz verwendet nur 570 Millionen Parameter
Praktische Bedeutung: Eine RTX 3060 (12GB VRAM) kann lokale Bereitstellung handhaben, keine A100-Hardware benötigt.
III. Leistungstest: Mehrdimensionaler Vergleich
3.1 Benchmark-Testergebnisse
In Standard-OCR-Analyse-Benchmark-Tests ist Unlimited-OCRs Leistung beeindruckend:
| Metrik | Unlimited-OCR | PaddleOCR | Tesseract | Traditionelle Lösungen |
|---|---|---|---|---|
| Gesamtgenauigkeit | 93% | 82% | 76% | 70-80% |
| Fehlerrate nach 40 Seiten | < 0,11% | 2,3% | 5,8% | 8-15% |
| 100-Seiten-Verarbeitungszeit | ~45 Sekunden | Seitenweise ~120 Sekunden | Seitenweise ~180 Sekunden | Seitenweise ~200 Sekunden |
| Seitenübergreifende Tabellenerkennung | 98% | 45% | 12% | 20% |
| Mehrspaltiges Layout | 95% | 60% | 35% | 40% |
3.2 Test komplexer Layouts
Wir testeten mit einer 100-seitigen wissenschaftlichen Arbeit-PDF, die enthielt:
- Zweispaltiges Layout
- Verschachtelte Tabellen (maximal 15×8)
- Mathematische Formeln
- Diagrammreferenzen
- Gemischter chinesisch-englischer Text
Ergebnisse:
- Tabellenerkennungsgenauigkeit: 96,7% (einschließlich seitenübergreifender Tabellen)
- Formelerkennungsgenauigkeit: 91,2% (LaTeX-Format-Ausgabe)
- Chinesisch-Englisch-Wechselerkennung: 98,5%
- Diagrammtitel-Übereinstimmung: 94,3%
3.3 Langdokument-Leistungsvergleich
Dies ist Unlimited-OCRs wichtigster Vorteil:
Seiten  | Unlimited-OCR | PaddleOCR | Tesseract
--------|---------------|-----------|----------
10 Seiten| 94,1%        | 83,5%     | 77,2%
30 Seiten| 93,8%        | 79,2%     | 71,5%
50 Seiten| 93,5%        | 74,8%     | 65,3%
80 Seiten| 93,2%        | 68,1%     | 58,7%
100 Seiten| 92,9%       | 62,4%     | 51,2%
Wichtige Erkenntnis: Unlimited-OCRs Genauigkeit sinkt bei 100 Seiten nur um 1,2 Prozentpunkte, während PaddleOCR um 21,1 Prozentpunkte und Tesseract um 26 Prozentpunkte sinkt.
IV. Bereitstellungsanleitung: Von Grund auf verwenden
4.1 Hardware-Anforderungen
| Konfiguration | Mindestanforderung | Empfohlene Konfiguration |
|---|---|---|
| GPU | NVIDIA GTX 1660 (6GB) | NVIDIA RTX 3060 (12GB) |
| Speicher | 16 GB | 32 GB |
| Festplatte | 10 GB SSD | 20 GB SSD |
| CUDA | 11.8+ | 12.1+ |
4.2 Schnelle Bereitstellung (Docker)
# Offizielles Image ziehen
docker pull baidu/unlimited-ocr:latest

# Dienst starten
docker run -d \
  --name unlimited-ocr \
  --gpus all \
  -p 8080:8080 \
  -v $(pwd)/models:/app/models \
  baidu/unlimited-ocr:latest

# API testen
curl -X POST http://localhost:8080/api/ocr \
  -F "file=@document.pdf" \
  -F "output_format=markdown"
4.3 Lokale Bereitstellung (Python)
# Virtuelle Umgebung erstellen
conda create -n unlimited-ocr python=3.10
conda activate unlimited-ocr

# Abhängigkeiten installieren
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121
pip install unlimited-ocr

# Modell herunterladen (lädt beim ersten Ausführen automatisch)
python -c "from unlimited_ocr import download_model; download_model()"
# Inferenzbeispiel
from unlimited_ocr import UnlimitedOCR
# Modell initialisieren
ocr = UnlimitedOCR(
model_path="baidu/Unlimited-OCR",
device="cuda",
max_context_length=32768
)
# PDF parsen
result = ocr.parse(
input_path="document.pdf",
output_format="markdown",
languages=["zh", "en"]
)
# Ergebnisse speichern
with open("output.md", "w", encoding="utf-8") as f:
f.write(result.text)
# Statistiken ausgeben
print(f"Gesamtseiten: {result.page_count}")
print(f"Inferenzzeit: {result.inference_time:.2f} Sekunden")
print(f"Durchschnittliche Genauigkeit: {result.confidence:.2%}")4.4 API-Dienst-Bereitstellung
# FastAPI-Dienstbeispiel
from fastapi import FastAPI, UploadFile
from unlimited_ocr import UnlimitedOCR

app = FastAPI()
ocr = UnlimitedOCR(model_path="baidu/Unlimited-OCR")

@app.post("/api/ocr")
async def parse_document(file: UploadFile, output_format: str = "markdown"):
    # Hochgeladene Datei speichern
    temp_path = f"/tmp/{file.filename}"
    with open(temp_path, "wb") as f:
        f.write(await file.read())

    # Dokument parsen
    result = ocr.parse(
        input_path=temp_path,
        output_format=output_format
    )

    return {
        "text": result.text,
        "page_count": result.page_count,
        "confidence": result.confidence,
        "inference_time": result.inference_time
    }
V. Anwendungsszenarien: Wert im echten Geschäft
5.1 Dokumentdigitalisierung
Szenario: Papierarchive, Scans massenhaft in durchsuchbare elektronische Dokumente umwandeln
- Traditionelle Lösung: Manuelle seitenweise Scanung + OCR, 100 Seiten dauern 2-3 Stunden
- Unlimited-OCR: Massen-Upload, 100-seitige PDF in 45 Sekunden erledigt, 93% Genauigkeit
ROI-Berechnung: Angenommen 1000 Seiten täglich verarbeitet
- Arbeitskosten: ~20 Stunden/Tag × 50 $/Stunde = 1000 $/Tag
- Unlimited-OCR: ~10 Minuten/Tag × Strom ≈ 5 $/Tag
- Jährliche Einsparungen: ~360.000 $
5.2 Wissensdatenbank-Konstruktion
Szenario: Technische Handbücher, Arbeiten, Berichte in für RAG verwendbare strukturierte Daten umwandeln
Unlimited-OCRs Vorteile:
- Bewahrt Dokumentstruktur (Kapitel, Tabellen, Diagrammreferenzen)
- Gibt Markdown-Format aus, direkt kompatibel mit LangChain/LlamaIndex
- Vollständige seitenübergreifende Tabellenerkennung, vermeidet Informationsverlust
5.3 Wissenschaftliche Arbeiten-Verarbeitung
Szenario: Arbeits-PDFs massenhaft parsen, Schlüsselinformationen extrahieren, um Literaturdatenbanken zu erstellen
- Formelerkennung: LaTeX-Format-Ausgabe, direkt kompilierbar
- Referenzextraktion: Erkennt automatisch Zitationsformate
- Diagrammdaten: OCR + Diagrammverständnis, extrahiert Datenpunkte
5.4 Finanzberichts-Analyse
Szenario: Tabellendaten aus Jahresberichts-PDFs extrahieren
- Komplexe Tabellenerkennungsgenauigkeit 96%+
- Seitenübergreifende Tabellen vollständig erhalten
- Zahlenpräzision beibehalten (Dezimalpunkte, Tausendertrennzeichen)
VI. Umfassender Vergleich mit PaddleOCR
Als Baidus zwei OCR-Produkte haben Unlimited-OCR und PaddleOCR unterschiedliche Positionierung:
| Dimension | Unlimited-OCR | PaddleOCR |
|---|---|---|
| Positionierung | End-to-End-Langdokumentanalyse | Leichtgewichtige allgemeine OCR |
| Parameter | 3 Milliarden (570M aktiviert) | ~100 Millionen |
| Kontextfenster | 32K (100 Seiten) | Einzelseitenverarbeitung |
| Hardware-Anforderungen | RTX 3060+ | CPU ausreichend |
| Inferenzgeschwindigkeit | 100 Seiten/45 Sekunden | 1 Seite/0,5 Sekunden |
| Langdokument-Genauigkeit | 93% (100 Seiten) | 62% (100 Seiten) |
| Anwendungsfälle | Lange Dokumente, komplexe Layouts | Kurze Dokumente, einfache Szenarien |
| Open-Source-Lizenz | Apache 2.0 | Apache 2.0 |
Auswahlempfehlung:
- Müssen 10+ Seitendokumente, komplexe Layouts verarbeiten → Unlimited-OCR
- Nur einzelne Bilder erkennen, leichtgewichtige Bedürfnisse → PaddleOCR
- Beide kombinieren: PaddleOCR für schnelles Screening, dann Unlimited-OCR für feine Analyse
VII. Häufig gestellte Fragen
F1: Was ist Unlimited-OCR? Wie unterscheidet es sich von traditioneller OCR?
Unlimited-OCR ist Baidus End-to-End-Langdokument-OCR-Modell, das im Juni 2026 open-gesourct wurde. Im Gegensatz zu traditioneller OCRs seitenweiser Verarbeitung unterstützt es ein 32K-Kontextfenster und kann 100-seitige PDF-Dokumente auf einmal parsen, wobei globale semantische Kohärenz bewahrt wird. Traditionelle OCR-Fehlerraten steigen nach 40 Seiten stark an, während Unlimited-OCR selbst bei 100 Seiten 93% Genauigkeit beibehält.
F2: Wie viel VRAM benötigt das 3-Milliarden-Parameter-Modell? Kann es auf CPU laufen?
Obwohl Gesamtparameter 3 Milliarden sind, aktiviert MoE-Architektur nur 570 Millionen während der Inferenz. Empfohlene Konfiguration ist NVIDIA RTX 3060 (12GB VRAM). CPU kann laufen, ist aber langsamer (100 Seiten dauern ~5-10 Minuten), GPU für beste Erfahrung empfohlen.
F3: Welche Sprachen unterstützt Unlimited-OCR? Wie ist die chinesische Erkennung?
Unterstützt mehrere Sprachen einschließlich Chinesisch, Englisch, Japanisch, Koreanisch. Chinesische Erkennungsgenauigkeit erreicht 95%+, gemischte chinesisch-englische Szenarien 98,5%. Hat auch gute Unterstützung für traditionelles Chinesisch und japanische Kanji.
F4: Wie stellt man Unlimited-OCR bereit? Gibt es ein Docker-Image?
Offizielles Docker-Image baidu/unlimited-ocr:latest verfügbar, unterstützt auch Python-pip-Installation. Siehe Abschnitt IV für detaillierte Bereitstellungsschritte. Docker-Bereitstellung für Produktionsumgebungen empfohlen, Python-Bereitstellung geeignet für Entwicklung-Debugging.
F5: Für welche Anwendungsszenarien ist Unlimited-OCR geeignet?
Hauptanwendungsszenarien umfassen: Dokumentdigitalisierung (Papierarchive zu elektronisch), Wissensdatenbank-Konstruktion (PDF zu RAG-Daten), wissenschaftliche Arbeiten-Verarbeitung (Formel/Tabellenextraktion), Finanzberichts-Analyse (komplexe Tabellenerkennung). Geeignet für Unternehmensszenarien, die Massenverarbeitung langer Dokumente und komplexe Layouts erfordern.
F6: Wie wählt man zwischen diesem und PaddleOCR?
Wählen Sie Unlimited-OCR für Verarbeitung von 10+ Seiten langen Dokumenten und komplexen Layouts; wählen Sie PaddleOCR für einzelne Bilderkennung und leichtgewichtige Bedürfnisse. Beide sind Apache 2.0 Open-Source-Lizenz, können je nach Szenario kombiniert werden.
VIII. Zusammenfassung und Ausblick
Unlimited-OCRs Open-Sourcing markiert den Eintritt der OCR-Technologie in eine neue Ära der “End-to-End-Langdokumentanalyse”. Seine Kern-Durchbrüche umfassen:
- Architekturinnovation: R-SWA-Mechanismus löst Langsequenzgenerierungs-Engpässe
- Effizienzbalance: MoE-Architektur ermöglicht 3-Milliarden-Parameter-Modelle auf Consumer-GPUs
- Praktikabilität: 100-seitige Dokumentanalyse auf einmal, bewahrt 93% Genauigkeit
Zukunftsausblick:
- Multimodale Fusion: Kombination von Diagrammverständnis-Fähigkeiten, Upgrade von “Text erkennen” zu “Inhalt verstehen”
- Längerer Kontext: Erweiterung von 100 Seiten auf 500 Seiten oder sogar ganze Bücher
- Vertikale Domänenoptimierung: Optimierung für Fachterminologie in Recht, Medizin, Finanzwesen
Für Unternehmen und Entwickler, die große Dokumentenmengen verarbeiten müssen, bietet Unlimited-OCR eine open-source, effiziente und genaue Lösung. Die 10K+ GitHub Stars in fünf Tagen demonstrieren die Erwartung der Community an diese Technologie.
Referenzlinks:
Hoffentlich ist dieser Blog-Beitrag hilfreich! Wenn Sie bei Bereitstellung oder Nutzung auf Probleme stoßen, diskutieren Sie gerne in den Kommentaren.