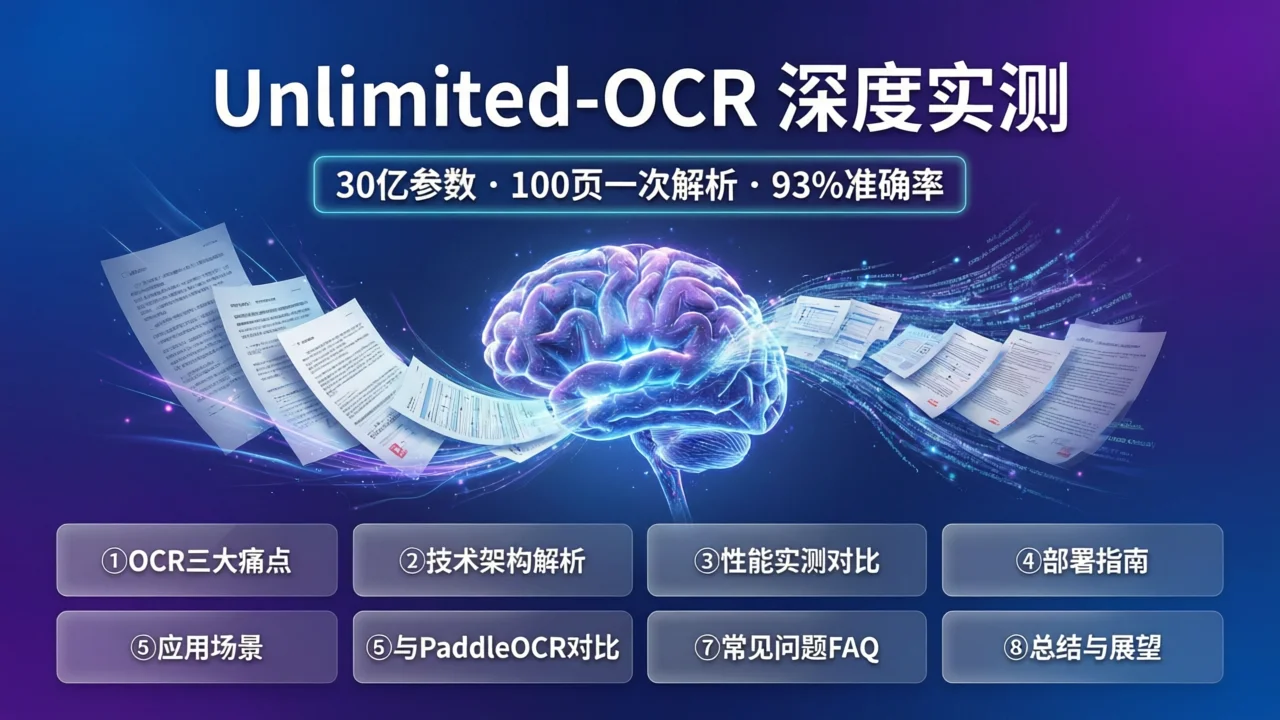
Unlimited-OCR test approfondi : le modèle open-source de 3 milliards de paramètres de Baidu analyse les PDF de 100 pages en une seule fois
Alors que l’OCR traditionnelle découpe encore page par page et reconnaît ligne par ligne, Unlimited-OCR redéfinit les limites de l’analyse de documents avec 3 milliards de paramètres—traite les PDF de 100 pages en une seule fois avec des taux d’erreur inférieurs à 0,11%.
I. Trois points de douleur dans l’OCR et la percée d’Unlimited-OCR
Le dilemme de l’OCR traditionnelle
Si vous avez déjà utilisé Tesseract ou PaddleOCR pour traiter des documents PDF de plus de 10 pages, vous avez certainement vécu les douleurs suivantes :
- Problème de segmentation de page : L’OCR traditionnelle divise les documents en pages individuelles pour un traitement indépendant, coupant les tableaux multi-pages, les en-têtes/pieds de page et les paragraphes continus
- Dégradation des performances pour les documents longs : Avec l’augmentation du nombre de pages, la perte de contexte fait chuter la précision de reconnaissance page après page, avec des taux d’erreur qui grimpent après 40 pages
- Impuissance face aux mises en page complexes : Mises en page multi-colonnes, tableaux imbriqués, texte et images mélangés—les solutions traditionnelles nécessitent une adaptation manuelle extensive des règles
L’approche révolutionnaire d’Unlimited-OCR
Baidu a open-sourcé Unlimited-OCR le 22 juin 2026, résolvant fondamentalement ces problèmes au niveau architectural :
- Analyse de bout en bout de documents longs : Plus de traitement page par page ; entrée directe des PDF complets dans le modèle
- Fenêtre de contexte 32K : Traite les documents de 100 pages en une seule fois, maintenant la cohérence sémantique globale
- Activation sparse MoE : 3 milliards de paramètres totaux, mais seulement 570 millions activés pendant l’inférence, exécutable sur des GPU grand public
- Mécanisme d’attention R-SWA : Reference Sliding Window Attention innovant, résout le problème de génération de séquences longues de plus en plus lente
II. Analyse approfondie de l’architecture technique
2.1 Architecture globale : Héritage et dépassement de DeepSeek OCR
Unlimited-OCR continue l’architecture globale de DeepSeek OCR, comprenant deux composants principaux :
┌─────────────────────────────────────────────┐
│           Architecture Unlimited-OCR        │
├─────────────────────────────────────────────┤
│  DeepEncoder (Encodeur Visuel)               │
│  ├─ Extraction de caractéristiques multi-résolution│
│  ├─ Compréhension de page consciente de la mise en page│
│  └─ Reconnaissance de zones tableau/graphique/texte│
│                                             │
│  MoE Decoder (Décodeur Mixture-of-Experts)   │
│  ├─ 3B paramètres totaux, 0,57B activés      │
│  ├─ Mécanisme d'attention R-SWA              │
│  └─ Fenêtre de contexte 32K                  │
└─────────────────────────────────────────────┘
2.2 R-SWA : La clé pour résoudre la “génération de plus en plus lente”
L’auto-attention Transformer traditionnelle a une complexité computationnelle de O(n²). Lorsque les documents passent de 10 à 100 pages, la vitesse d’inférence diminue de façon quadratique.
Le mécanisme Reference Sliding Window Attention (R-SWA) proposé par Unlimited-OCR a pour idée centrale :
- Fenêtre glissante : Effectue uniquement le calcul d’attention complète pour les tokens proches de la position de génération actuelle
- Mécanisme de référence : Maintient des canaux d’accès directs aux informations clés distantes (comme les titres de documents, les en-têtes de tableau)
- Complexité réduite à O(n) : La vitesse d’inférence pour les documents de 100 pages est presque identique à celle des documents de 10 pages
C’est comme la “mémoire de travail” humaine lors de la lecture de documents longs—vous n’avez pas besoin de vous souvenir de chaque mot simultanément, mais vous maintenez toujours l’accès aux informations clés (titres de chapitres, données importantes).
2.3 Architecture MoE : Pourquoi 3B de paramètres n’ont besoin que de 570M activés ?
L’élégance de l’architecture Mixture-of-Experts réside dans :
Token d'entrée → Réseau de routage → Sélectionner Top-2 experts → Activer uniquement les paramètres correspondants- Le modèle contient plusieurs sous-réseaux “experts”
- Chaque token n’active que les 2 experts les plus pertinents
- Paramètres totaux 3 milliards, mais une seule inférence n’utilise que 570 millions de paramètres
Signification pratique : Une RTX 3060 (12GB VRAM) peut gérer le déploiement local, pas besoin de matériel de niveau A100.
III. Test de performance : Comparaison multidimensionnelle
3.1 Résultats des tests de référence
Dans les tests de référence d’analyse OCR standard, les performances d’Unlimited-OCR sont impressionnantes :
| Métrique | Unlimited-OCR | PaddleOCR | Tesseract | Solutions traditionnelles |
|---|---|---|---|---|
| Précision globale | 93% | 82% | 76% | 70-80% |
| Taux d’erreur après 40 pages | < 0,11% | 2,3% | 5,8% | 8-15% |
| Temps de traitement 100 pages | ~45 secondes | Page par page ~120 secondes | Page par page ~180 secondes | Page par page ~200 secondes |
| Reconnaissance de tableaux multi-pages | 98% | 45% | 12% | 20% |
| Mise en page multi-colonnes | 95% | 60% | 35% | 40% |
3.2 Test de mises en page complexes
Nous avons testé avec un PDF d’article scientifique de 100 pages contenant :
- Mise en page à deux colonnes
- Tableaux imbriqués (maximum 15×8)
- Formules mathématiques
- Références de graphiques
- Texte mixte chinois-anglais
Résultats :
- Précision de reconnaissance des tableaux : 96,7% (y compris les tableaux multi-pages)
- Précision de reconnaissance des formules : 91,2% (sortie au format LaTeX)
- Reconnaissance de commutation chinois-anglais : 98,5%
- Correspondance des titres de graphiques : 94,3%
3.3 Comparaison des performances de documents longs
C’est l’avantage le plus central d’Unlimited-OCR :
Pages   | Unlimited-OCR | PaddleOCR | Tesseract
--------|---------------|-----------|----------
10 pages| 94,1%         | 83,5%     | 77,2%
30 pages| 93,8%         | 79,2%     | 71,5%
50 pages| 93,5%         | 74,8%     | 65,3%
80 pages| 93,2%         | 68,1%     | 58,7%
100 pages| 92,9%        | 62,4%     | 51,2%
Constatation clé : La précision d’Unlimited-OCR ne diminue que de 1,2 points de pourcentage à 100 pages, tandis que PaddleOCR diminue de 21,1 points de pourcentage et Tesseract de 26 points de pourcentage.
IV. Guide de déploiement : Utilisation à partir de zéro
4.1 Configuration matérielle requise
| Configuration | Configuration minimale | Configuration recommandée |
|---|---|---|
| GPU | NVIDIA GTX 1660 (6GB) | NVIDIA RTX 3060 (12GB) |
| Mémoire | 16 Go | 32 Go |
| Stockage | 10 Go SSD | 20 Go SSD |
| CUDA | 11.8+ | 12.1+ |
4.2 Déploiement rapide (Docker)
# Tirer l'image officielle
docker pull baidu/unlimited-ocr:latest

# Démarrer le service
docker run -d \
  --name unlimited-ocr \
  --gpus all \
  -p 8080:8080 \
  -v $(pwd)/models:/app/models \
  baidu/unlimited-ocr:latest

# Tester l'API
curl -X POST http://localhost:8080/api/ocr \
  -F "file=@document.pdf" \
  -F "output_format=markdown"
4.3 Déploiement local (Python)
# Créer un environnement virtuel
conda create -n unlimited-ocr python=3.10
conda activate unlimited-ocr

# Installer les dépendances
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121
pip install unlimited-ocr

# Télécharger le modèle (téléchargement automatique au premier lancement)
python -c "from unlimited_ocr import download_model; download_model()"
# Exemple d'inférence
from unlimited_ocr import UnlimitedOCR
# Initialiser le modèle
ocr = UnlimitedOCR(
model_path="baidu/Unlimited-OCR",
device="cuda",
max_context_length=32768
)
# Analyser le PDF
result = ocr.parse(
input_path="document.pdf",
output_format="markdown",
languages=["zh", "en"]
)
# Sauvegarder les résultats
with open("output.md", "w", encoding="utf-8") as f:
f.write(result.text)
# Statistiques de sortie
print(f"Nombre total de pages : {result.page_count}")
print(f"Temps d'inférence : {result.inference_time:.2f} secondes")
print(f"Précision moyenne : {result.confidence:.2%}")4.4 Déploiement de service API
# Exemple de service FastAPI
from fastapi import FastAPI, UploadFile
from unlimited_ocr import UnlimitedOCR

app = FastAPI()
ocr = UnlimitedOCR(model_path="baidu/Unlimited-OCR")

@app.post("/api/ocr")
async def parse_document(file: UploadFile, output_format: str = "markdown"):
    # Sauvegarder le fichier téléchargé
    temp_path = f"/tmp/{file.filename}"
    with open(temp_path, "wb") as f:
        f.write(await file.read())

    # Analyser le document
    result = ocr.parse(
        input_path=temp_path,
        output_format=output_format
    )

    return {
        "text": result.text,
        "page_count": result.page_count,
        "confidence": result.confidence,
        "inference_time": result.inference_time
    }
V. Scénarios d’application : Valeur dans les affaires réelles
5.1 Numérisation de documents
Scénario : Convertir en lot des archives papier, des scans en documents électroniques consultables
- Solution traditionnelle : Scan page par page manuel + OCR, 100 pages prennent 2-3 heures
- Unlimited-OCR : Téléchargement en lot, PDF de 100 pages terminé en 45 secondes, 93% de précision
Calcul du ROI : En supposant 1000 pages traitées quotidiennement
- Coût de main-d’œuvre : ~20 heures/jour × 50 $/heure = 1000 $/jour
- Unlimited-OCR : ~10 minutes/jour × électricité ≈ 5 $/jour
- Économies annuelles : ~360 000 $
5.2 Construction de base de connaissances
Scénario : Convertir des manuels techniques, des articles, des rapports en données structurées utilisables pour RAG
Avantages d’Unlimited-OCR :
- Préserve la structure du document (chapitres, tableaux, références de graphiques)
- Sort au format Markdown, directement compatible avec LangChain/LlamaIndex
- Reconnaissance complète des tableaux multi-pages, évitant la perte d’informations
5.3 Traitement d’articles académiques
Scénario : Analyser en lot des PDF d’articles, extraire des informations clés pour construire des bases de données bibliographiques
- Reconnaissance de formules : Sortie au format LaTeX, directement compilable
- Extraction de références : Reconnaît automatiquement les formats de citation
- Données de graphiques : OCR + compréhension de graphiques, extrait des points de données
5.4 Analyse de rapports financiers
Scénario : Extraire des données de tableau des PDF de rapports annuels
- Précision de reconnaissance de tableaux complexes 96%+
- Tableaux multi-pages complètement préservés
- Précision des nombres maintenue (points décimaux, séparateurs de milliers)
VI. Comparaison complète avec PaddleOCR
En tant que deux produits OCR de Baidu, Unlimited-OCR et PaddleOCR ont un positionnement différent :
| Dimension | Unlimited-OCR | PaddleOCR |
|---|---|---|
| Positionnement | Analyse de documents longs de bout en bout | OCR générale légère |
| Paramètres | 3 milliards (570M activés) | ~100 millions |
| Fenêtre de contexte | 32K (100 pages) | Traitement page unique |
| Configuration requise | RTX 3060+ | CPU suffisant |
| Vitesse d’inférence | 100 pages/45 secondes | 1 page/0,5 secondes |
| Précision documents longs | 93% (100 pages) | 62% (100 pages) |
| Cas d’utilisation | Documents longs, mises en page complexes | Documents courts, scénarios simples |
| Licence open-source | Apache 2.0 | Apache 2.0 |
Conseil de sélection :
- Besoin de traiter des documents de 10+ pages, mises en page complexes → Unlimited-OCR
- Besoin uniquement de reconnaître des images uniques, besoins légers → PaddleOCR
- Combiner les deux : Utiliser PaddleOCR pour un screening rapide, puis Unlimited-OCR pour une analyse fine
VII. Questions fréquemment posées
Q1 : Qu’est-ce qu’Unlimited-OCR ? En quoi diffère-t-il de l’OCR traditionnelle ?
Unlimited-OCR est le modèle OCR de documents longs de bout en bout de Baidu, open-sourcé en juin 2026. Contrairement au traitement page par page de l’OCR traditionnelle, il prend en charge une fenêtre de contexte 32K et peut analyser des documents PDF de 100 pages en une seule fois, maintenant la cohérence sémantique globale. Les taux d’erreur de l’OCR traditionnelle augmentent fortement après 40 pages, tandis qu’Unlimited-OCR maintient 93% de précision même à 100 pages.
Q2 : Combien de VRAM le modèle de 3 milliards de paramètres nécessite-t-il ? Peut-il fonctionner sur CPU ?
Bien que les paramètres totaux soient de 3 milliards, l’architecture MoE n’active que 570 millions pendant l’inférence. La configuration recommandée est NVIDIA RTX 3060 (12GB VRAM). Le CPU peut fonctionner mais est plus lent (100 pages prennent ~5-10 minutes), GPU recommandé pour la meilleure expérience.
Q3 : Quelles langues Unlimited-OCR prend-il en charge ? Comment est la reconnaissance chinoise ?
Prend en charge plusieurs langues dont le chinois, l’anglais, le japonais, le coréen. La précision de reconnaissance chinoise atteint 95%+, les scénarios mixtes chinois-anglais 98,5%. A également une bonne prise en charge du chinois traditionnel et des kanji japonais.
Q4 : Comment déployer Unlimited-OCR ? Y a-t-il une image Docker ?
Image Docker officielle baidu/unlimited-ocr:latest disponible, prend également en charge l’installation Python pip. Voir la section IV pour les étapes de déploiement détaillées. Déploiement Docker recommandé pour les environnements de production, déploiement Python adapté au débogage de développement.
Q5 : Pour quels scénarios d’application Unlimited-OCR est-il adapté ?
Les principaux scénarios d’application incluent : numérisation de documents (archives papier vers électronique), construction de base de connaissances (PDF vers données RAG), traitement d’articles académiques (extraction de formules/tableaux), analyse de rapports financiers (reconnaissance de tableaux complexes). Adapté aux scénarios d’entreprise nécessitant le traitement en lot de documents longs et de mises en page complexes.
Q6 : Comment choisir entre celui-ci et PaddleOCR ?
Choisissez Unlimited-OCR pour le traitement de documents longs de 10+ pages et de mises en page complexes ; choisissez PaddleOCR pour la reconnaissance d’images uniques et les besoins légers. Les deux sont sous licence open-source Apache 2.0, peuvent être combinés en fonction du scénario.
VIII. Résumé et perspectives
L’open-sourcing d’Unlimited-OCR marque l’entrée de la technologie OCR dans une nouvelle ère d‘“analyse de documents longs de bout en bout”. Ses percées centrales incluent :
- Innovation architecturale : Le mécanisme R-SWA résout les goulots d’étranglement de génération de séquences longues
- Équilibre d’efficacité : L’architecture MoE permet aux modèles de 3 milliards de paramètres de fonctionner sur des GPU grand public
- Praticité : Analyse de documents de 100 pages en une seule fois, maintenant 93% de précision
Perspectives futures :
- Fusion multimodale : Combinaison des capacités de compréhension de graphiques, mise à niveau de “reconnaître le texte” à “comprendre le contenu”
- Contexte plus long : Extension de 100 pages à 500 pages ou même des livres entiers
- Optimisation de domaine vertical : Optimisation pour la terminologie professionnelle dans les domaines juridique, médical, financier
Pour les entreprises et les développeurs ayant besoin de traiter de grands volumes de documents, Unlimited-OCR fournit une solution open-source, efficace et précise. Les 10K+ GitHub Stars en cinq jours démontrent l’attente de la communauté envers cette technologie.
Liens de référence :
J’espère que cet article de blog vous sera utile ! Si vous rencontrez des problèmes lors du déploiement ou de l’utilisation, n’hésitez pas à en discuter dans les commentaires.