Zusammenfassung
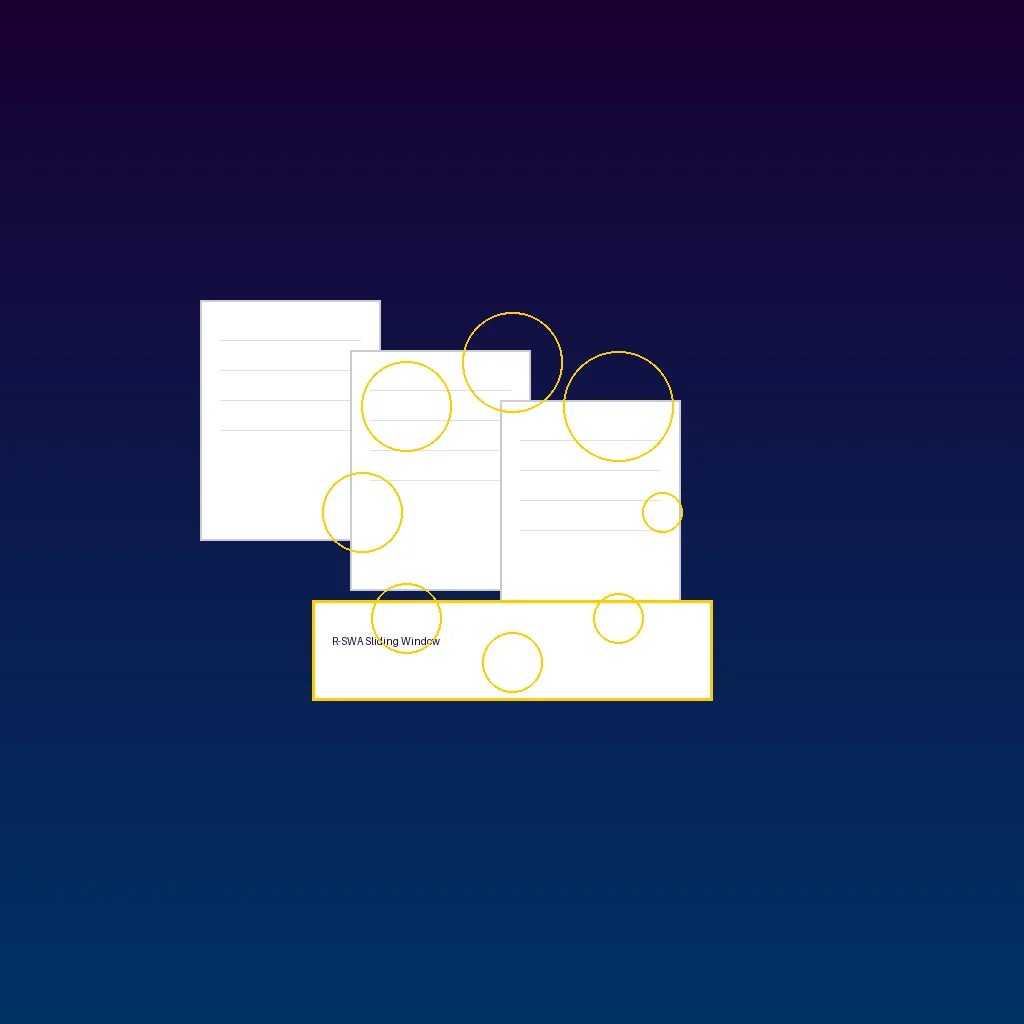
Baidus Open-Source Unlimited-OCR schafft, was herkömmliche OCR-Tools nicht können: Ein komplettes 100-seitiges PDF in einem Durchgang lesen, ohne Speicherexplosion oder Geschwindigkeitsverlust – mit nur 3 Milliarden Parametern. Das Geheimnis ist R-SWA (Reference Sliding Window Attention) – das Modell arbeitet wie ein Mensch, der Text abschreibt und nur das Original und die letzten paar geschriebenen Zeichen betrachtet.
Warum herkömmliche OCR bei langen Dokumenten scheitert
Wer schon einmal Tesseract oder Adobe Acrobat mit einem gescannten PDF über 10 Seiten benutzt hat, kennt das:
- Seitenweise Verarbeitung: OCR-Engines verarbeiten jede Seite einzeln, setzen den Zustand zurück. Tabellen über Seitengrenzen werden zerschnitten.
- Speicherexplosion: End-to-End-OCR-Modelle (wie DeepSeek-OCR) haben einen KV-Cache, der linear mit der Textlänge wächst.
- Formatverlust: Mehrspaltige Layouts, seitenübergreifende Tabellen gehen bei der seitenweisen Verarbeitung verloren.
Die Kerninnovation: R-SWA-Aufmerksamkeitsmechanismus
Wie ein Mensch, der Text abschreibt
Das Baidu-Forschungsteam ließ sich vom menschlichen Abschreiben inspirieren. Beim Abschreiben eines Buches:
- Die Augen schauen auf den Quelltext (visuelle Token)
- Die letzten Zeichen sind noch im Blickfeld (Token im Schiebefenster)
- Früherer Text muss nicht mehr neu gelesen werden
Das ist die Kernidee von Reference Sliding Window Attention (R-SWA).
Technische Details
R-SWA macht zwei Dinge:
- Visuelle Token werden eingefroren: Bildkodierung erfolgt einmal und bleibt unverändert.
- Ausgabe-Token nutzen ein Schiebefenster: Jedes neue Token beachtet nur die letzten 128 generierten Token. Ältere Token werden aus dem Fenster geschoben.
Ergebnis: Ob 5 oder 100 Seiten – der KV-Cache bleibt während der Dekodierung konstant.
Leistung: 93% Genauigkeit, 32K-Kontextfenster
Benchmark-Ergebnisse
| Modell | Score | Anmerkung |
|---|---|---|
| Unlimited-OCR | 93,92% | OmniDocBench v1.6 SOTA |
| DeepSeek-OCR | 87,70% | Baseline |
| GPT-4o | ~88% | Closed-Source |
| Tesseract 5 | ~72% | Traditionelle OCR |
Zwei Nutzungsmöglichkeiten
Option 1: Hugging Face Space (ohne Konfiguration)
Besuchen Sie akhaliq/Unlimited-OCR für eine schnelle Online-Demo.
Option 2: Lokale Bereitstellung
git clone https://github.com/baidu/Unlimited-OCR.git
cd Unlimited-OCR
conda create -n unlimited-ocr python=3.10
conda activate unlimited-ocr
pip install -r requirements.txt
python inference.py --input dokument.pdf --mode base --output ergebnis.md
Vergleich mit traditioneller OCR
| Aspekt | Unlimited-OCR | Tesseract 5 | Adobe Acrobat | PaddleOCR |
|---|---|---|---|---|
| Langdokumente | ✅ 100 Seiten auf einmal | ❌ Seite für Seite | ❌ Seite für Seite | ❌ Seite für Seite |
| Open Source | ✅ MIT | ✅ Apache 2.0 | ❌ Kommerziell | ✅ Apache 2.0 |
| Offline | ✅ | ✅ | ❌ | ✅ |
FAQ
Q1: Wie viel VRAM wird benötigt?
Etwa 8 GB. Durch MoE-Architektur werden nur ~500 Millionen Parameter aktiviert.
Q2: Welche Sprachen werden unterstützt?
Hauptsächlich Chinesisch und Englisch, beste Genauigkeit für diese Sprachen.
Q3: Kommerzielle Nutzung erlaubt?
Ja, MIT-Lizenz erlaubt kommerzielle Nutzung.
Q4: Verarbeitungsdauer für 100 Seiten?
Auf einer RTX 4090 etwa 3-5 Minuten für ein Standard-PDF.
Q5: Ohne GPU nutzbar?
Theoretisch ja, aber extrem langsam. Empfehlung: Hugging Face Space oder Apple MLX auf M-Series Macs.
Wir hoffen, dieser Artikel war hilfreich! Weitere KI-Tools finden Sie in unserem Ultimativen KI-Tool-Guide 2026.