一句话总结
百度开源的 Unlimited-OCR 用 30 亿参数做到了传统 OCR 工具做不到的事:一次性读完 100 页 PDF,内存不爆炸,速度不衰减。核心秘密是一个叫 R-SWA 的注意力机制——让模型像人抄书一样,只看原文和最近写下的几个字,而不是反复回读所有内容。
为什么传统 OCR 处理长文档这么痛苦?
如果你曾经用 Tesseract 或者 Adobe Acrobat 处理过超过 10 页的扫描件 PDF,你一定经历过这些:
- 逐页处理:OCR 引擎一页一页识别,每页重置状态,跨页表格被截断
- 内存飙升:端到端 OCR 模型(如 DeepSeek-OCR)的 KV Cache 随文本长度线性增长,40 页文档就能吃掉 24GB 显存
- 格式丢失:多栏排版、跨页表格、页眉页脚在逐页处理中彻底乱序
这不是工具不好用,而是架构层面的天花板。传统 OCR 把每一页当作独立任务,缺乏”整本书”的全局视野。
Unlimited-OCR 的核心创新:R-SWA 注意力机制
像人抄书一样工作
百度研究团队从人类抄书的行为中获得了灵感。想象你在抄一本书:
- 你的眼睛看着原文(视觉 token)
- 你刚写下的最后几个字还在视野内(滑动窗口内的历史 token)
- 更早的内容你已经不需要重新阅读了(被滑出窗口的 token)
这就是 Reference Sliding Window Attention(R-SWA,参考滑动窗口注意力) 的核心思想。
技术细节
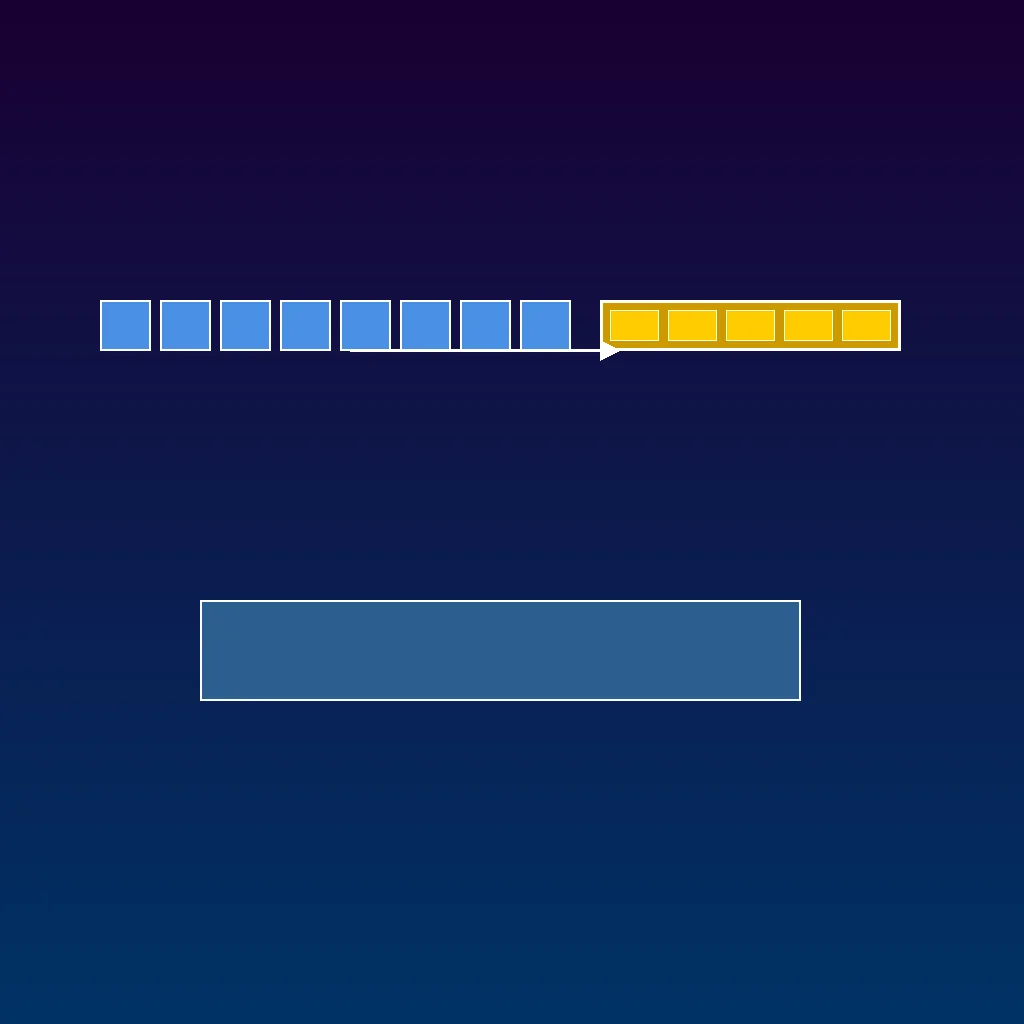 图 1:R-SWA 注意力机制架构 — 视觉 token 冻结,输出 token 使用 128 长度滑动窗口
传统多头注意力(MHA)中,每生成一个新 token,KV Cache 就增加一条记录,内存随输出长度线性增长。R-SWA 做了两件事:
- 视觉 token 冻结:图像编码一次后保持不变,不参与滑动窗口的状态更新。这避免了标准滑动窗口注意力会逐渐模糊图像特征的问题。
- 输出 token 滑动窗口:每个新生成的 token 只关注最近 128 个已生成的 token,更早的 token 被推出窗口。KV Cache 变成固定长度的队列——新 token 入队,最旧的 token 出队。
结果:无论文档是 5 页还是 100 页,解码阶段的 KV Cache 大小恒定不变。
与 DeepSeek-OCR 的关系
Unlimited-OCR 构建在 DeepSeek-OCR 的开源基础之上:
- 保留 DeepEncoder 视觉编码器(将 1024×1024 的 PDF 页面压缩为 256 个 token)
- 将解码器替换为 MoE(混合专家)架构,总参数 30 亿,推理时仅激活约 5 亿
- 所有标准注意力层替换为 R-SWA
性能实测:93% 准确率,32K 上下文窗口
基准测试成绩
 图 2:Unlimited-OCR 与其他 OCR 模型在 OmniDocBench v1.5/v1.6 上的性能对比
在 OmniDocBench v1.5/v1.6 标准 OCR 基准测试中:
| 模型 | 综合得分 | 备注 |
|---|---|---|
| Unlimited-OCR | 93.92% | OmniDocBench v1.6 SOTA |
| DeepSeek-OCR | 87.70% | 基线模型 |
| GPT-4o | ~88% | 闭源参考 |
| Tesseract 5 | ~72% | 传统 OCR 参考 |
相比 DeepSeek-OCR 提升 6.22 个百分点,在 40+ 页长文档上表现尤为稳定。
实际使用场景
- 单张图片:使用 “Gundam” 模式(动态分辨率),适合高精度单页识别
- 多页文档/PDF:使用 “Base” 模式,一次性输入整个文档,无需拆分页面
- 32K 上下文窗口:理论上可处理约 100 页标准 PDF(每页约 300 token)
两种使用方式:在线体验 vs 本地部署
方式一:Hugging Face Space 在线体验(零配置)
最快的体验方式是使用社区部署的 Hugging Face Space:
- 访问 akhaliq/Unlimited-OCR
- 上传图片或 PDF 文件
- 选择快速裁剪模式或完整解析模式
- 等待处理,获取 Markdown 格式输出
适合快速验证效果,但受限于共享 GPU 资源,长文档可能需要排队。
方式二:本地部署(完整控制)
 图 3:Unlimited-OCR 本地部署命令行界面 — 支持单页和多页文档处理
硬件要求:
- GPU:NVIDIA GPU,至少 8GB VRAM(推荐 RTX 3090/4090)
- 内存:16GB+
- 磁盘:模型约 6GB
安装步骤:
# 1. 克隆仓库
git clone https://github.com/baidu/Unlimited-OCR.git
cd Unlimited-OCR

# 2. 创建虚拟环境
conda create -n unlimited-ocr python=3.10
conda activate unlimited-ocr

# 3. 安装依赖
pip install -r requirements.txt

# 4. 下载模型(从百度网盘或 Hugging Face)
# 百度网盘:https://pan.baidu.com/s/xxx
# Hugging Face:自动下载

# 5. 运行推理
python inference.py \
  --input your_document.pdf \
  --mode base \
  --output result.md
使用 vLLM 加速推理(推荐生产环境):
# 安装 vLLM
pip install vllm

# 启动服务
python -m vllm.entrypoints.openai.api_server \
  --model baidu/Unlimited-OCR \
  --max-model-len 32768

# 调用 API
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "baidu/Unlimited-OCR", "messages": [...]}'
Apple Silicon 用户:MLX 版本
社区已经将 Unlimited-OCR 移植到 Apple MLX 框架(LoJexLLM/Unlimited-OCR-MLX),M1/M2/M3 Mac 用户可以原生运行。
Unlimited-OCR vs 传统 OCR 工具对比
| 维度 | Unlimited-OCR | Tesseract 5 | Adobe Acrobat OCR | PaddleOCR |
|---|---|---|---|---|
| 长文档处理 | ✅ 一次性 100 页 | ❌ 逐页处理 | ❌ 逐页处理 | ❌ 逐页处理 |
| KV Cache | 恒定(R-SWA) | N/A | N/A | N/A |
| 表格识别 | ✅ 跨页表格保持完整 | ⚠️ 简单表格 | ✅ 较好 | ⚠️ 一般 |
| 公式识别 | ✅ LaTeX 输出 | ❌ 不支持 | ⚠️ 有限 | ⚠️ 有限 |
| 模型大小 | ~6GB | ~30MB | 云端 | ~100MB |
| 开源 | ✅ MIT | ✅ Apache 2.0 | ❌ 商业 | ✅ Apache 2.0 |
| 离线运行 | ✅ | ✅ | ❌ | ✅ |
| GPU 要求 | 8GB+ VRAM | CPU 即可 | 云端 | 可选 GPU |
结论:Unlimited-OCR 不是要替代 Tesseract 这种轻量级工具,而是解决端到端长文档 OCR 这个特定痛点。如果你的场景是扫描件 PDF 批量数字化、合同/财报全文提取、学术论文解析,Unlimited-OCR 是目前开源方案中的最优选择。
社区生态与最新进展
- Hugging Face Space:akhaliq/Unlimited-OCR 可在线体验
- Apple MLX 移植:LoJexLLM/Unlimited-OCR-MLX 支持 Mac 原生运行
- vLLM 集成:社区提供了完整的 vLLM 推理脚本(uv-scripts/ocr)
- GitHub 仓库:baidu/Unlimited-OCR,MIT 许可证,53 个 open issues,28 个 open PRs,社区活跃
常见问题(FAQ)
Q1: Unlimited-OCR 需要多少显存?
推理时约需 8GB VRAM。虽然模型总参数 30 亿,但 MoE 架构在推理时仅激活约 5 亿参数,加上 R-SWA 保持 KV Cache 恒定,实际显存占用远低于同参数量的 dense 模型。
Q2: 支持哪些语言的文档识别?
Unlimited-OCR 主要训练数据来自中英文文档,对中文和英文的识别效果最佳。其他语言(日文、韩文等)也能识别但准确率可能略低。
Q3: 与 PaddleOCR 有什么区别?应该选哪个?
PaddleOCR 是传统 OCR 管线(检测 + 识别),轻量、快速、适合单页场景。Unlimited-OCR 是端到端模型,优势在于长文档一次性处理和复杂版面理解。如果你只需要识别单张发票或名片,PaddleOCR 更合适;如果要处理整本扫描书或长篇合同,Unlimited-OCR 更优。
Q4: 可以商用吗?
可以。Unlimited-OCR 采用 MIT 许可证,允许商业使用、修改和分发,无需额外授权。
Q5: 处理 100 页 PDF 需要多长时间?
取决于 GPU 性能。在 RTX 4090 上,100 页标准 PDF(每页约 300 token 输出)大约需要 3-5 分钟。瓶颈主要在视觉编码阶段,解码阶段因为 R-SWA 保持恒定速度,不会随页数增加而变慢。
Q6: 没有 GPU 能用吗?
理论上可以,但速度会非常慢。CPU 推理 30 亿参数模型不实用。建议没有 GPU 的用户使用 Hugging Face Space 在线体验,或者考虑使用 Apple MLX 版本在 M 系列芯片 Mac 上运行。
希望这篇博客文章对您有所帮助!如果你正在寻找更多 AI 工具,不妨看看我们的 2026 年 AI 工具终极指南,涵盖 50+ 款工具的深度评测。