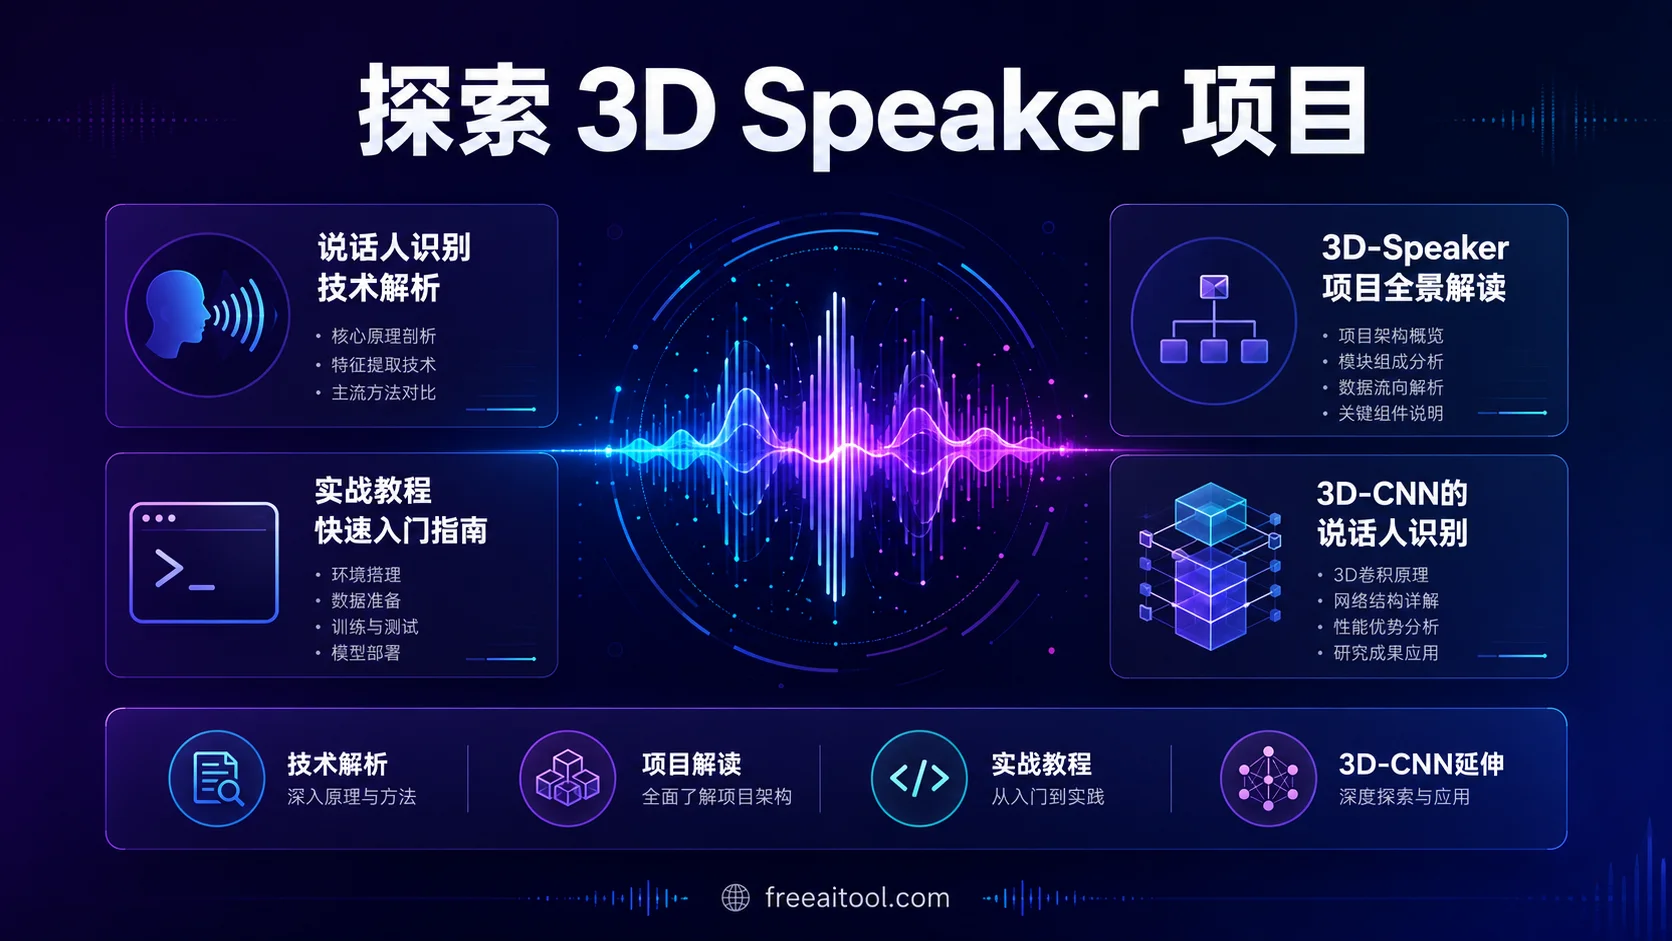
一、說話人識別技術解析
1.1 技術定義與核心區別
- 說話人識別(Speaker Identification)
透過未知語音與資料庫中的已知聲紋進行1:N匹配,確定說話人身份。 - 說話人驗證(Speaker Verification)
透過1:1匹配確認說話人是否與宣告的身份一致。 - 語音識別(Speech Recognition)
關注語音內容轉寫,不涉及身份判斷。
1.2 技術流程
- 特徵提取
從語音中提取梅爾頻率倒譜係數(MFCC)、線性預測倒譜係數(LPCC)等聲學特徵。 - 模型訓練
使用深度神經網路(如CNN、ECAPA-TDNN)學習說話人特徵。 - 聲紋註冊
為每個說話人生成唯一的聲紋模板。 - 實時識別
將新語音與聲紋庫匹配,返回最可能的說話人列表。
1.3 典型應用場景
| 領域 | 應用案例 |
|---|---|
| 司法取證 | 犯罪錄音與嫌疑人聲紋庫匹配 |
| 智慧客服 | 來電自動識別老客戶,提供個性化服務 |
| 智慧家居 | 透過聲紋解鎖裝置,區分不同使用者指令 |
| 醫療健康 | 慢性病患者語音身份核驗,確保電子病歷安全(研究參考) |
二、3D-Speaker專案全景解讀
2.1 專案定位與優勢
3D-Speaker由ModelScope團隊開發,專注於多裝置、多距離、多方言場景下的說話人識別,其核心優勢包括:
- 多模態支援:可能融合3D音訊或視覺資料提升魯棒性
- 工業級資料集:覆蓋14種漢語方言、5類裝置(手機/平板/錄音筆等)、近場/遠場錄音
- 先進模型庫:提供Res2Net、ECAPA-TDNN等SOTA模型,在VoxCeleb等基準測試中表現優異
2.2 核心元件說明
2.2.1 3D-Speaker資料集
| 維度 | 詳細說明 |
|---|---|
| 方言覆蓋 | 14種漢語方言(北方官話、吳語、粵語等) |
| 裝置型別 | PC、手機、iPad、錄音筆、陣列麥克風 |
| 錄音距離 | 近場(<0.8米)、遠場(>0.8米) |
| 資料規模 | 1000+說話人,每個說話人包含多裝置、多距離錄音 |
| 獲取方式 | 資料集官網申請下載,含跨裝置/距離/方言測試集 |
(資料來源:3D-Speaker論文)
2.2.2 預訓練模型效能
模型在VoxCeleb1-O測試集上的表現:
| 模型 | 引數量(百萬) | 等錯誤率(EER%) |
|---|---|---|
| ECAPA-TDNN | 20.8 | 0.52 |
| ERes2Net-large | 22.46 | 0.64 |
| CAM++ | 7.2 | 1.04 |
(注:EER越低表示效能越優)
2.2.3 說話人日誌(Diarization)
支援多人對話場景下的”誰在何時說話”分析:
- AMI_SDM資料集DER:21.76%
- Aishell-4資料集DER:10.30%
三、實戰教學:快速入門指南
3.1 環境搭建
# 複製程式碼倉庫
git clone https://github.com/modelscope/3D-Speaker.git
cd 3D-Speaker

# 安裝依賴
pip install -r requirements.txt
3.2 使用預訓練模型
from modelscope.pipelines import pipeline
from modelscope.utils.constant import Tasks

# 初始化說話人驗證管道
verifier = pipeline(task=Tasks.speaker_verification, model='damo/speech_eres2net_sv_zh-cn_3dspeaker_16k')

# 比對兩段語音是否同一人
audio1 = 'path/to/audio1.wav'
audio2 = 'path/to/audio2.wav'
result = verifier([audio1, audio2])

print(f"相似度得分: {result['scores'][0]:.4f}")
# 輸出示例:相似度得分: 0.9321 (閾值通常設為0.85)
3.3 自訂聲紋庫
from speakerlab.utils.builder import build_embedding_model

# 載入ERes2Net模型
model = build_embedding_model('eres2net')

# 提取聲紋特徵
import torchaudio
waveform, sr = torchaudio.load('user_audio.wav')
embeddings = model.encode_wav(waveform, sample_rate=sr)

# 儲存到資料庫
import numpy as np
np.save('user_emb.npy', embeddings)
四、技術延伸:3D-CNN的說話人識別
除了3D-Speaker專案,另一種創新方法是使用3D捲積神經網路(3D-CNN)建模語音的時-頻-空間特徵:
4.1 核心思想
- 將語音片段視為三維張量(時間×頻率×通道)
- 透過3D捲積核同時捕獲區域性和全域性特徵
- 在VoxCeleb資料集上EER可達3.22%(論文)
4.2 程式碼實踐
# 使用PyTorch實現3D-CNN
import torch.nn as nn

class Speaker3DCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv1 = nn.Conv3d(1, 64, (3,5,5))
        self.pool = nn.MaxPool3d((1,2,2))
        self.fc = nn.Linear(64*10*12, 512)  # 假設輸入尺寸為20x64x64

    def forward(self, x):
        x = self.pool(nn.ReLU()(self.conv1(x)))
        x = x.view(x.size(0), -1)
        return self.fc(x)
五、開發者資源推薦
-
[入門教學] 從零構建說話人識別系統
- 手把手教學MFCC特徵提取與CNN模型訓練
-
[會議應用] 在線會議說話人分離實戰
- 結合3D-Speaker實現會議紀要自動生成
-
[擴充套件閱讀] 微軟Azure說話人識別文件
- 瞭解商業化API的設計思路
六、總結與展望
3D-Speaker專案透過多維度資料採集和先進模型架構,正在突破傳統聲紋識別的侷限性。對於開發者而言,其開源特性降低了技術落地門檻;對於研究者,豐富的資料集為語音表徵解耦等前沿方向提供了實驗基礎。隨著多模態融合技術的發展,未來聲紋識別有望與面部識別、行為分析結合,構建更精準的生物特徵認證體系。
立即行動:
- 存取GitHub倉庫獲取程式碼
- 申請3D-Speaker資料集
- 嘗試將ECAPA-TDNN模型部署到您的語音應用中
技術演進永無止境,現在就加入開源社群,共同塑造聲音識別的未來!