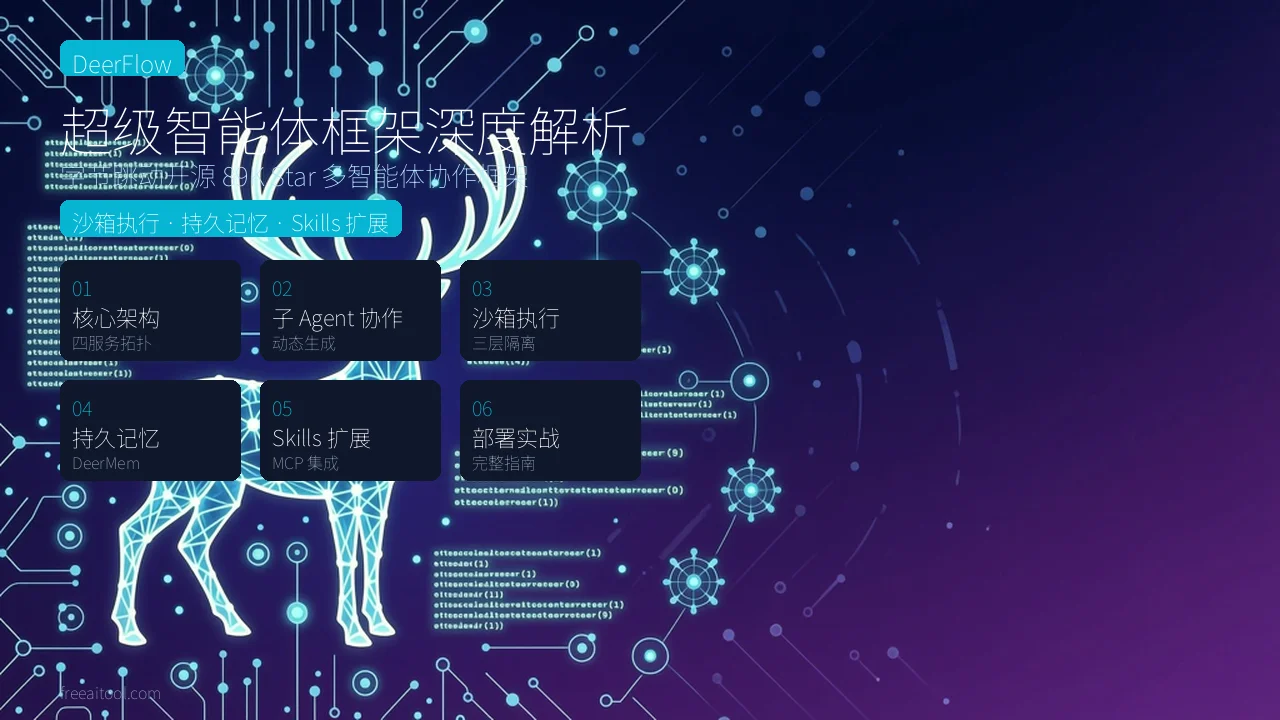
DeerFlow 2.0 深度解析:字节跳动开源 89K Star Super Agent 框架全面拆解
2026 年 2 月 28 日,字节跳动开源了 DeerFlow 2.0——一个从深度研究助手进化为全栈 Super Agent Harness 的开源框架。短短数月,GitHub Star 突破 89K,冲上全球 Trending 第一。
这不是又一个 Agent 框架的重复造轮子。DeerFlow 2.0 是一次彻底的架构重写,从”可编排的框架”变成了”开箱即用的 Agent 运行时环境”。它内置了沙箱执行、持久记忆、Skills 扩展、子 Agent 协作等企业级特性,让你无需从零搭建就能运行复杂的 AI Agent 任务。
本文将全面拆解 DeerFlow 2.0 的核心架构、关键技术、本地部署实战,并与 AutoGPT、CrewAI 进行横向对比,帮你判断它是否值得投入生产环境。
一、DeerFlow 2.0 是什么?从研究助手到 Super Agent Harness
1.1 DeerFlow 的演进历程
DeerFlow(Deep Exploration and Efficient Research Flow)最初是一个基于 LangChain 和 LangGraph 的深度研究助手,专注于多源信息检索和报告生成。
2026 年 2 月,字节跳动发布了 DeerFlow 2.0——一次完全的架构重写。新版本不再是一个”你需要自己组装的框架”,而是一个”电池已装好的 Super Agent Harness”。
关键变化:
- 从框架到运行时:不再只是提供编排能力,而是包含完整的执行环境
- 从单 Agent 到多 Agent 协作:支持动态生成子 Agent,并行/串行执行
- 从无状态到持久记忆:内置 DeerMem 系统,支持跨会话知识保留
- 从封闭到可扩展:Skills 系统 + MCP 集成,能力边界不断扩展
1.2 为什么 DeerFlow 2.0 能爆火?
89K+ Star 的背后,是 DeerFlow 2.0 精准击中了当前 Agent 框架的痛点:
- 安全隔离缺失:大多数框架直接在宿主机执行代码,DeerFlow 提供完整的沙箱隔离
- 记忆系统薄弱:AutoGPT 等只有基础记忆,DeerFlow 的 DeerMem 支持 FTS5 检索和多后端
- 生产部署困难:CrewAI 等缺乏企业级部署方案,DeerFlow 内置 Docker + K8s + Helm
- 扩展性不足:DeerFlow 的 Skills 系统 + MCP 让能力边界可以无限扩展
二、核心架构拆解:四服务拓扑 + 单向依赖分层
2.1 四服务拓扑结构
DeerFlow 2.0 采用清晰的四服务架构,Nginx 作为统一入口:
┌─────────────────────────────────────────┐
│           Nginx (端口 2026)              │
│         反向代理 + 浏览器入口            │
└──────────────┬──────────────────────────┘
               │
    ┌──────────┴──────────┐
    │                     │
    ▼                     ▼
┌─────────┐         ┌──────────┐
│ Gateway │         │ Frontend │
│  :8001  │         │  :3000   │
│ FastAPI │         │ Next.js  │
│ + Agent │         │  React   │
└─────────┘         └──────────┘
    │
    ▼ (可选)
┌──────────┐
│Provisioner│
│  :8002   │
│ K8s 模式  │
└──────────┘
路由规则:
/api/langgraph/*→ Gateway 的 LangGraph 兼容运行时/api/*(其他)→ Gateway REST 路由/*(非 API)→ Frontend
这种设计的好处是:浏览器只需访问 http://localhost:2026,Nginx 自动分发到正确的后端服务。
2.2 后端单向依赖分层
DeerFlow 2.0 的后端采用严格的单向依赖分层,这是企业级代码质量的体现:
Harness 层(backend/packages/harness/deerflow/):
- 可发布的 Agent 框架核心
- 包含:编排、工具、沙箱、模型、MCP、Skills、记忆、配置
- 导入前缀:
deerflow.*
App 层(backend/app/):
- 未发布的应用代码
- 包含:FastAPI Gateway、IM 渠道集成
- 导入前缀:
app.*
核心规则: App 可以导入 deerflow,但 deerflow 永远不导入 app。这个边界在 CI 中强制执行。
这种分层的好处是:Harness 层可以独立发布,其他项目可以直接复用 DeerFlow 的 Agent 框架核心,而不需要引入整个应用。
2.3 Agent 运行时路径
所有运行模式通过 Gateway 执行 Agent,中间件链在模型调用前依次执行:
- ThreadDataMiddleware - 设置 workspace/uploads/outputs 路径
- UploadsMiddleware - 注入上传文件列表
- SandboxMiddleware - 获取沙箱实例
- SummarizationMiddleware - 上下文压缩
- TitleMiddleware - 自动生成对话标题
- TodoListMiddleware - 任务跟踪
- ViewImageMiddleware - 视觉模型图像处理
- ClarificationMiddleware - 处理澄清请求
这种中间件模式让每个关注点都被清晰分离,易于扩展和维护。
三、关键技术深度解析
3.1 子 Agent 协作:动态生成 + 并行/串行执行
DeerFlow 2.0 的 Lead Agent 可以动态生成子 Agent,每个子 Agent 具有:
- 独立的上下文范围
- 独立的工具集
- 独立的终止条件
- 独立的执行 ID
协作模式:
并行执行:独立的只读研究任务可以并发运行。Lead Agent 会评估并行收益,避免过度扇出(当时间节省低于重复发现成本时,会选择串行)。
串行执行:有共享文件或顺序依赖的任务保持在 Lead Agent 中,或者使用单个子 Agent 的顺序链。
上下文模式:
context_mode="isolated"(默认):子 Agent 只接收委托的提示context_mode="snapshot":子 Agent 还接收父对话的保留历史和压缩摘要
工具限制: 子 Agent 支持工具白名单和黑名单,黑名单优先级高于白名单。
结果处理: 子 Agent 返回结构化结果,Lead Agent 验证和综合。支持验收标准验证(如 tests_passed、file:<path> exists、json-valid)。
3.2 沙箱执行:三层隔离保障安全
DeerFlow 支持三种沙箱执行模式:
Local Execution(本地执行):
- 直接在宿主机运行沙箱代码
- 仅用于开发环境
- 不推荐用于生产
Docker Execution(Docker 执行):
- 在隔离的 Docker 容器中运行
- 生产环境推荐
- 使用
AioSandboxProvider
Docker + Kubernetes:
- 通过 Provisioner 服务在 K8s Pod 中运行
- 大规模部署使用
文件系统结构:
/mnt/user-data/
├── uploads/          ← 用户上传的文件
├── workspace/        ← Agent 的工作目录
└── outputs/          ← 最终交付物
安全隔离:
- 线程隔离:每个对话有独立的数据目录,上传文件验证防止路径遍历
- 沙箱隔离:生产环境使用 Docker
AioSandboxProvider,支持网络策略(isolated、allowlist、开放) - MCP 隔离:每个 MCP 服务器在独立进程中运行,运行时环境变量解析
3.3 DeerMem 持久记忆:跨会话知识保留
DeerFlow 2.0 内置 DeerMem 记忆系统,支持多种后端:
DeerMem(默认):
- 本地文件系统存储
- 支持 FTS5/BM25 检索
- 用户完全控制
可选后端:
mem0:支持托管平台或自托管honcho:用户模型记忆,服务端处理openviking:使用 langchain-openviking 包
记忆结构:
memory/
├── memory.json              ← 用户全局摘要 (user + history)
└── agents/
    └── {agent_name}/
        └── facts/
            └── *.md         ← Agent 特定的事实文件
记忆提取:
- 自动捕获用户输入和最终助手回复
- 排除工具调用的助手回合
- 按范围、持久性和权威性分类
记忆检索:
- FTS5/BM25 检索,选择最高组合分数(BM25 + 时间衰减 + 置信度)
- 支持中文分词(需要
memory-zh额外依赖) - 可选的相关性排序,结合词汇相关性和置信度
淘汰策略:
- 默认:基于置信度的淘汰
hybrid-v1:结合置信度(65%)、确认新鲜度(25%)、访问热度(10%)
3.4 Skills 扩展系统:能力边界无限扩展
DeerFlow 2.0 的 Skills 系统让能力边界可以无限扩展:
Skills 结构:
skills/
├── public/          ← 提交到仓库的公共 Skills
└── custom/          ← gitignore 的自定义 Skills
工具来源:
- 内置工具:
present_files、ask_clarification、view_image、review_skill_package - 配置工具:
bash、read_file、write_file、str_replace、ls、Web 搜索/获取 - MCP 工具:通过 MCP 服务器提供,每个服务器独立进程运行
Skills 加载:
- 懒加载:按需发现和加载,减少启动时间
- 热重载:支持运行时更新
- 工具合并:
get_available_tools()合并三个来源
HITL 工具审批:
Ask:执行前显示完整操作Auto:使用现有模型配置文件进行无工具审查Full:在操作者策略内跳过单独审查
四、本地部署实战:从零到运行
4.1 系统要求
硬件要求:
- 本地开发:4 vCPU, 8 GB RAM, 20 GB SSD(推荐 8 vCPU, 16 GB RAM)
- Docker 开发:4 vCPU, 8 GB RAM, 25 GB SSD
- 长期运行服务器:8 vCPU, 16 GB RAM, 40 GB SSD(推荐 16 vCPU, 32 GB RAM)
软件要求:
- Python 3.12+
- Node.js 22+
- pnpm 10.26.2+
- uv(Python 包管理器)
- nginx
- Docker Desktop / Docker Engine(Docker 模式)
- Docker Compose v2.24+(Docker 模式)
4.2 方式一:Docker 部署(推荐)
步骤 1:克隆仓库
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow
步骤 2:交互式配置
make setup这会启动交互式向导,生成 config.yaml 和 .env 文件(约 2 分钟)。你需要配置:
- LLM 提供商(OpenAI、Anthropic、本地模型等)
- 搜索 API(Tavily、Bing 等)
- 沙箱模式(Local、Docker、K8s)
步骤 3:初始化 Docker
make docker-init拉取沙箱镜像(仅首次或镜像更新时需要)。
步骤 4:启动服务
make docker-start启动所有服务(自动从 config.yaml 检测沙箱模式)。
步骤 5:访问应用
打开浏览器访问:http://localhost:2026
其他 Docker 命令:
make docker-logs    # 查看日志
make docker-stop    # 停止服务
make docker-restart # 重启服务
4.3 方式二:本地开发部署
步骤 1:克隆仓库
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow
步骤 2:交互式配置
make setup步骤 3:检查先决条件
make check验证 Node.js 22+、pnpm、uv、nginx 是否已安装。
步骤 4:安装依赖
make install安装后端 + 前端依赖 + pre-commit hooks。
步骤 5:(可选)预拉取沙箱镜像
make setup-sandbox如果使用 Docker/Container 沙箱,建议执行此步骤。
步骤 6:启动服务
make dev步骤 7:访问应用
打开浏览器访问:http://localhost:2026
4.4 配置验证
运行配置检查:
make doctor报告明显的占位符 API 密钥作为不完整配置。
4.5 启动模式对比
| 模式 | 命令 | 用途 |
|---|---|---|
| 本地前台 | make dev | 开发调试 |
| 本地守护进程 | make dev-daemon | 后台运行 |
| Docker 开发 | make docker-start | 容器化开发 |
| Docker 生产 | make up | 生产部署 |
五、横向对比:DeerFlow 2.0 vs AutoGPT vs CrewAI
5.1 架构理念对比
DeerFlow 2.0:
- Super Agent Harness:不仅仅是框架,而是包含完整运行时环境
- Batteries Included:内置文件系统、记忆、Skills、沙箱
- 生产就绪:从设计之初就考虑生产部署
AutoGPT:
- 自主 Agent:强调完全自主执行
- 插件生态:通过插件扩展能力
- 实验性质:更多用于研究和实验
CrewAI:
- 多 Agent 协作:专注于 Agent 团队协作
- 角色定义:通过角色和任务定义工作流
- 轻量级:相对简单的编排框架
5.2 核心特性对比
| 特性 | DeerFlow 2.0 | AutoGPT | CrewAI |
|---|---|---|---|
| 沙箱执行 | ✅ 完整的隔离沙箱(Local/Docker/K8s) | ❌ 直接在宿主机执行 | ❌ 无沙箱 |
| 持久记忆 | ✅ DeerMem + 多后端支持 | ⚠️ 基础记忆 | ❌ 无持久记忆 |
| Skills 系统 | ✅ 可扩展的 Skills + MCP | ⚠️ 插件系统 | ❌ 无 Skills |
| 子 Agent 协作 | ✅ 动态生成 + 并行/串行 | ⚠️ 基础任务分解 | ✅ 角色协作 |
| 生产部署 | ✅ Docker + K8s + Helm | ⚠️ 基础 Docker | ⚠️ 基础部署 |
| 安全隔离 | ✅ 多层隔离(线程/沙箱/MCP) | ❌ 最小隔离 | ❌ 无隔离 |
| IM 集成 | ✅ 飞书/Slack/Telegram/Discord/DingTalk | ❌ 无 | ❌ 无 |
| Web UI | ✅ Next.js 完整界面 | ⚠️ 基础界面 | ❌ 无 |
| 上下文压缩 | ✅ 自动摘要 + 目标管理 | ❌ 无 | ❌ 无 |
| 工具审批 | ✅ HITL 审批流程 | ❌ 无 | ❌ 无 |
5.3 适用场景对比
DeerFlow 2.0 最适合:
- 需要安全沙箱执行的生产环境
- 复杂的多步骤研究和分析任务
- 需要持久记忆和上下文管理的长期项目
- 企业级部署(需要 IM 集成、权限控制)
- 需要可扩展 Skills 的定制化场景
AutoGPT 最适合:
- 自主任务执行的实验和研究
- 快速原型验证
- 不需要严格安全隔离的场景
CrewAI 最适合:
- 明确角色分工的团队协作任务
- 相对简单的多 Agent 工作流
- 不需要复杂基础设施的场景
5.4 技术成熟度对比
DeerFlow 2.0:
- ✅ 企业级特性(安全、隔离、监控)
- ✅ 完整的部署方案(Docker、K8s、Helm)
- ✅ 丰富的集成(IM、MCP、LangSmith)
- ✅ 活跃的社区和维护(字节跳动支持)
AutoGPT:
- ⚠️ 更多用于研究和实验
- ⚠️ 生产部署需要额外工作
- ✅ 活跃的开源社区
CrewAI:
- ⚠️ 专注于特定用例(角色协作)
- ⚠️ 基础设施支持有限
- ✅ 简单易用
六、DeerFlow 2.0 的其他亮点
6.1 上下文管理
目标系统:用户可以设置线程范围的 /goal 完成条件,Agent 根据目标调整行为。
上下文压缩:SummarizationMiddleware 自动压缩旧历史,保留最近的助手/工具活动,系统指令在压缩后保留。
任务笔记:支持基于证据的决策,任务状态跟踪和验证。
6.2 流式传输
SSE 流:支持 per-chunk 消息和有界的 values 快照。stream_subgraphs 模式下,子 Agent 发布命名空间 SSE 事件。
LangGraph SDK 兼容:标准 LangGraph SDK 客户端可以直接与 DeerFlow 通信,无需单独的 LangGraph 服务器。
6.3 可观测性
追踪支持:LangSmith、Langfuse、Monocle 集成。
Token 使用仪表板:工作区 UI 显示 token 使用情况,子 Agent 使用量归属到调度步骤。
6.4 定时任务
调度器:工作区页面 /workspace/scheduled-tasks,config.yaml → scheduler.enabled 控制,非交互式运行丢弃 ask_clarification。
6.5 浏览器控制
Agentic Browser:支持代理浏览器控制,WebSocket 连接用于实时交互,需要 threads:write 权限。
七、总结:DeerFlow 2.0 值得投入生产环境吗?
DeerFlow 2.0 不是又一个 Agent 框架的重复造轮子,而是一次从”可编排的框架”到”开箱即用的 Agent 运行时环境”的进化。
核心优势:
- 完整的生产就绪特性:沙箱隔离、持久记忆、安全控制、IM 集成
- 强大的编排能力:动态子 Agent 生成、并行/串行执行、上下文管理
- 可扩展的架构:Skills 系统、MCP 集成、多后端支持
- 企业级部署:Docker、Kubernetes、Helm、多实例支持
适合谁:
- 需要在生产环境运行 AI Agent 的企业
- 需要安全沙箱执行的敏感场景
- 需要持久记忆和上下文管理的长期项目
- 需要 IM 集成和权限控制的团队
不适合谁:
- 只需要简单 Agent 原型的开发者(用 AutoGPT 或 CrewAI 更快)
- 不需要安全隔离的实验场景
- 资源受限的环境(DeerFlow 需要 8GB+ RAM)
89K+ Star 的背后,是 DeerFlow 2.0 精准击中了当前 Agent 框架的痛点。如果你需要在生产环境运行复杂的 AI Agent 任务,DeerFlow 2.0 是目前最成熟的选择之一。
参考链接:
希望这篇博客文章对您有所帮助!
常见问题(FAQ)
Q1: DeerFlow 2.0 和 DeerFlow 1.0 有什么区别?
A: DeerFlow 2.0 是一次完全的架构重写。1.0 是一个基于 LangChain 的深度研究助手,专注于多源信息检索和报告生成。2.0 进化为 Super Agent Harness,内置了沙箱执行、持久记忆、Skills 扩展、子 Agent 协作等企业级特性,从”可编排的框架”变成了”开箱即用的 Agent 运行时环境”。
Q2: DeerFlow 2.0 需要多少资源才能运行?
A: 本地开发环境最低需要 4 vCPU、8 GB RAM、20 GB SSD。推荐使用 8 vCPU、16 GB RAM。Docker 部署需要额外 25 GB SSD 用于镜像存储。生产环境建议 16 vCPU、32 GB RAM、40 GB SSD。
Q3: DeerFlow 2.0 支持哪些 LLM 提供商?
A: DeerFlow 2.0 支持 OpenAI、Anthropic、本地模型(通过 Ollama 等)等多种 LLM 提供商。配置通过 make setup 交互式向导完成,可以在 config.yaml 中灵活切换。
Q4: DeerFlow 2.0 的沙箱执行安全吗?
A: DeerFlow 2.0 提供三层安全隔离:线程隔离(每个对话有独立数据目录)、沙箱隔离(Docker/K8s 容器)、MCP 隔离(每个 MCP 服务器独立进程)。生产环境推荐使用 Docker 或 K8s 沙箱模式,支持网络策略(isolated、allowlist、开放)。
Q5: DeerFlow 2.0 和 AutoGPT、CrewAI 相比有什么优势?
A: DeerFlow 2.0 的核心优势是生产就绪:完整的沙箱隔离(AutoGPT/CrewAI 无沙箱)、持久记忆系统(DeerMem + 多后端)、Skills 扩展系统、企业级部署方案(Docker + K8s + Helm)、IM 集成(飞书/Slack/Telegram/Discord/DingTalk)。AutoGPT 更适合实验研究,CrewAI 更适合简单的角色协作任务。
Q6: DeerFlow 2.0 可以离线运行吗?
A: 可以。DeerFlow 2.0 支持本地模型(通过 Ollama 等),搜索功能可以配置为本地搜索引擎。但某些功能(如 Web 搜索、MCP 工具)可能需要网络连接。
Q7: DeerFlow 2.0 的 Skills 系统如何工作?
A: Skills 系统支持三种工具来源:内置工具(如 present_files、ask_clarification)、配置工具(如 bash、read_file、write_file)、MCP 工具(通过 MCP 服务器提供)。Skills 按需懒加载,支持热重载,可以无限扩展 Agent 的能力边界。
Q8: DeerFlow 2.0 适合个人开发者吗?
A: 适合,但有一定学习曲线。个人开发者可以用 DeerFlow 2.0 运行复杂的研究任务、自动化工作流、代码生成等。但如果你只需要简单的 Agent 原型,AutoGPT 或 CrewAI 可能更快上手。DeerFlow 2.0 的优势在于生产环境的稳定性和可扩展性。